下中国象棋赢了Jev!扩散智能推出决策模型,判断正确率达95%
智东西
作者 | 王涵
编辑 | 李水青
智东西10月28日报道,今天,深圳大模型厂商扩散智能(DiffuSpace)发布并开源 扩散语言模型Clover-35B-A3B-Preview ,该模型采用混合专家架构(MoE), 总参数350亿、激活参数30亿 ,支持思考模式。
该公司发布的基准测试结果显示,Clover-35B-A3B-Preview在SWE-bench Verified、Terminal-Bench2.1等6项智能体编程及工具使用任务评测中,排名同级别模型中的第一, 超过同规模自回归模型Qwen3.6-35B-A3B 。
HuggingFace:
https://huggingface.co/Diffuspace/Clover-35B-A3B-Preview
GitHub:
https://github.com/DiffuSpace/Clover-35B-A3B-Preview
ModelScope:
https://modelscope.cn/models/Diffuspace/Clover-35B-A3B-Preview
申请在线体验:https://chat.diffuspace.ai/
同时,扩散智能还推出了 Clover-35B-A3B-Preview的决策模型 ,面向快速、结构化的判断任务,支持独立模式和联合模式两种作答方式,该模型将在后续发布。
不同于TypeSafe的Jev等开源决策模型的单点评估思路,联合模式以全局统筹的方式开展推理,省去多次交互的耗时,使多项判断相互参照、规避逻辑冲突,一次性完成一组关联决策,实现更快、更稳定的推理结果。
在包含500组、2420道关联问题的内部验证中, 联合模式答对95.0% ,并在80.4%的问题组中全部答对。相比之下,同一模型独立作答时,两项成绩分别为 89.8%和62.4% ;Jev在相同题目的历史评测中分别为 63.6%和15.8% 。
在对比案例中,针对合同中的判断问题,Clover-35B-A3B-Preview决策模型的联合模式的 5项判断全部正确 ,独立模式答对4项,Jev答对2项。
该决策模型还和Jev展开了一场中国象棋的对弈,结果是 扩散智能的决策模型执黑获胜 。
扩散智能于2026年成立于深圳,由港大NLP实验室联合主管孔令鹏教授,以及其博士生龚珊三、叶佳成联合创立。核心团队长期研究扩散语言模型,是全球最早探索该路线的团队之一,在条件生成、离散信号建模、Scaling三大dLLM(扩散大语言模型)核心问题上取得全球领先突破。
该团队早在2022年就启动dLLM前沿研究,提出了DiffuSeq,开创了扩散模型处理序列到序列文本生成(Seq2Seq)的技术路径。2025年4月,其推出扩散语言模型Dream 7B, 至今Dream系列模型累计在Hugging Face下载超270万次 。
10月9日,扩散智能首次公布融资,其连续完成两轮融资,总金额数亿元人民币,创下公开披露的 全球dLLM最大规模融资纪录 。
一、6项Agent测评第一,单卡GB300生成速度达680 tokens/s
在基准测试方面,Clover-35B-A3B-Preview在智能体编程与工具使用任务中表现较好。 在本次对比的6项Agent评测中,该模型均取得了所列模型中的最高分 。
其中,SWE-bench Verified达到73.6分,Terminal-Bench2.1达到51.7分,τ³ Overall达到65.3分,超过了同为扩散语言模型的LLaDA2.2 flash、Mercury 2.5,以及 同尺寸的自回归模型Qwen3.6-35B-A3B和Qwen3.5-35B-A3B 。
在指令遵循、知识、逻辑推理和长文本理解等多项评测中,其成绩达到或超过同规模自回归模型,GPQA Diamond、ZebraLogic和AA-LCR分别达到83.8、95.8和72.0分。
在推理效率方面,团队使用覆盖代码编写、终端操作和工具调用等场景的内部Agent任务执行记录进行测试。
端侧部署方面,Clover-35B-A3B-Preview在 单张NVIDIA GB300 GPU 上,以BF16精度、batch size=1,达到 680 tokens/s 的整体生成速度。
此外,在单张NVIDIA H200 GPU上,Clover达到 515tokens/s ,高于DFlash2方案的365 tokens/s。
与其他代表性轻量级、高效推理或端侧部署模型的对比中,Clover-35B-A3B-Preview 在9项评测中的6项取得最高分 ,优势覆盖知识推理、工具使用与智能体编程。
二、路线规划28步完成,49项Agent任务耗时中位数仅1.52秒
基于Clover-35B-A3B-Preview在推理、工具使用以及编程上的能力,用户可以借助该模型完成 路径规划、WebMCP任务、模拟桌面环境、智能体调度等工作 。
例如,用户要查询“从匹兹堡CMU到最近的Wendy’s需要开车多久”。Clover识别出结果偏离目标,逐步加入城市、街区和邮编改写检索,并在页面卡住后两次重置、重填路线,最终找到目标门店,查得驾车距离 2.0公里、车程约3分钟。
本次对照中,Clover-35B-A3B-Preview用 28步、169.9秒 完成任务;Qwen3.6 Flash用满30步、耗时578.3秒,仍停留在距起点347公里、车程约4.5小时的门店,未通过任务评判。
通过网页提供的工具,Clover-35B-A3B-Preview可以连续完成开票、课程注册、金额汇总、事件状态与客户信息查询等任务。
在完整的49项任务、每项3次尝试的评测中,Clover的Agent执行耗时 中位数为1.52秒 ,Gemini 3.6 Flash为8.86秒。
此外,Clover-35B-A3B-Preview还可以创建私有项目并邀请成员。在相同的智能体框架、提示词、工具和浏览器配置下,本次运行中Clover-35B-A3B-Preview用 13步、169.9秒 完成任务,Qwen 3.6 Flash用21步、392.3秒完成。
该案例中用户要求用单个HTML文件模拟一个桌面环境,支持窗口拖动,并能打开多个小应用。
Clover-35B-A3B-Preview生成了包含程序坞、窗口系统以及记事本、计算器、时钟、天气和设置等应用的模拟桌面。
在演示中,用户可以打开应用、输入文本、操作计算器并调整设置。
在城市低空无人机调度演示中,模型通常需要将复合空管报文解析为禁飞区解除、航点修改、任务分配、禁飞区半径调整和紧急调度等多项任务。
Clover-35B-A3B-Preview在 0.97秒后 同时完成处理呈现5项正确结果。Qwen在3.78秒展示结果,还将UAV5的测绘任务误解析为医疗任务。
三、 重构双向门控Delta网络,兼顾推理速度与性能
Clover-35B-A3B-Preview能够兼顾推理速度与性能表现,背后是扩散智能人团队针对性的架构优化。
在Clover-35B-A3B-Preview中,扩散智能团队完成了 双向门控Delta网络(Bidirectional GDN) 的重构设计,针对历史记忆与块内去噪两条链路采用 差异化计算范式 。
模型已生成的上下文信息依托GDN递归状态实现高效压缩,当前块内Token则借助双向Softmax注意力完成细粒度交互。
在核心机制上,技术团队 将历史记忆读出作为独立信息单元 ,与块内Token纳入同一次Softmax运算开展信息筛选,由模型自主学习在推理过程中对历史信息与当前块信息的依赖权重。
团队同时新增可学习块大小校准机制,用于缓解块内Token数量增加带来的历史权重稀释问题。
针对局部特征提取环节,扩散智能团队还 为右侧上下文搭建了独立的零初始化卷积分支 。该方案基于预训练因果卷积的原有行为,让模型分别学习左右双向特征表征。
这套架构将紧凑长程记忆、可选择的块内交互能力与双向局部感知能力融合,使GDN架构更加适配块级并行去噪范式。
结语:押注开源端侧Agent路线,harness产品近期上线
当前大模型产业仍由自回归架构主导,推理栈、Agent框架和部署工具链大多围绕其建立,扩散语言要真正进入产业,要体现出自身与现有工具生态的兼容性、开发者迁移成本和规模化交付的稳定性。
扩散智能选择以开源、端侧、智能体能力作为切入点,正是希望降低试用门槛,方便开发者与终端厂商快速开展验证,加速技术落地。
与此同时,扩散智能团队透露其正在研发智能体运行框架(harness)及桌面编程客户端。相关工具尚处于开发阶段,计划于近期上线。
资讯由采集器定时从公开的机器人 / AI 信息源自动聚合。
相关内容
3149元起,iQOO Neo12首发2K 185Hz屏幕,称游戏体验“史上最接近”PC
智东西 作者 | 云鹏 编辑|李水青 智东西10月28日消息,刚刚,vivo旗下iQOO正式发布了新一代性能旗舰机iQOO Neo12系列,其首发了2K 185Hz屏幕,搭载了第五代骁龙8至尊版与自研电竞芯片Q3。 价格方面,Neo12系列国补后3149元起,共有5个版本,顶配16GB+1TB版本国补到手价5149元。 除了手机,今天iQOO还发布了3249元起售的iQOO Pad Pro 8.8英寸版,同样搭载第五代骁龙8至尊版与自研电竞芯片Q3,屏幕刷新率165Hz。 回到手机,这块屏我们并不陌生,此前智东西已在维信诺屏幕技术发布会上报道过这块屏幕及其背后技术,屏幕发光材料“天空之镜”,是
实测蚂蚁灵光2.0:不是中国版Muse,是中国化Muse
智东西 作者 | 毕伟豪 编辑|漠影 近几月,Muse的出现,带火了Personal Agent,也让整个行业开始 持续思考Personal Agent这一产品形态 。 但Muse的成功,显然不是引入形式就能复制的,依托长期记忆和云端虚拟机,让Agent能够进行持续的事务管理,这套打法思路非常清楚,但想要真正实现,显然 还有很多“形式”之外的“内容” 。 10月27日,蚂蚁集团发布了灵光2.0版本,将产品定位从强调对话和应用生成的AI助手,进一步推到 “能管事的个人助理” 。 灵光2.0版本从形式上看, 是“中国版”Muse ,但从内容上, 更像是“中国化“的Muse 。 因为蚂蚁集团并不是简
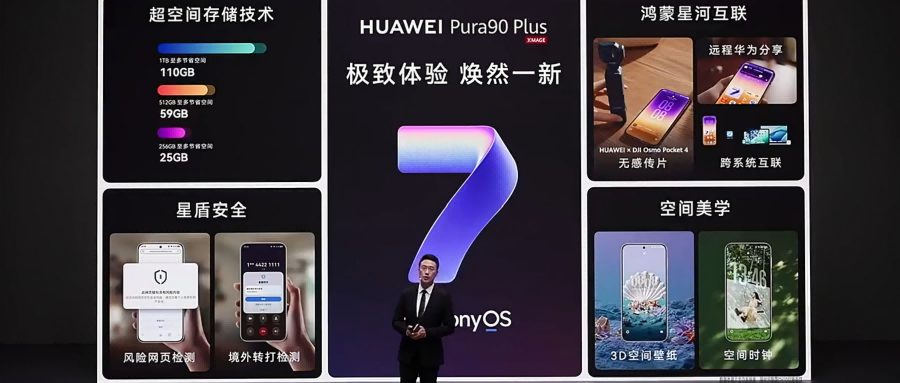
何刚升任董事后首秀!甩出八款华为终端新品,详解韬芯片黑科技
智东西 作者 | 杨京丽 编辑 | 李水青 智东西10月28日报道,今日,华为发布Pura90 Plus、畅享100系列、FreeClip 2耳夹耳机潮玩拼色版本、华为路由X2 Pro、华为全能充智能移动电源等多款新品,覆盖多条产品线。 此次发布会由华为董事、终端BG CEO何刚主持,这也是其 升任华为董事后主持的首场发布会 。何刚首先解读了 Mate 90系列的十大黑科技 ,主要包括钇晶宝石设计、第二代玲珑屏、全彩显示技术、光学昆仑玻璃、全系旗舰韬芯片、第三代红枫原色影像、18EV超高动态主摄、睿影Z10模块相机、四卡三待和多设备互助通信共享等。 Pura90 Plus 是Pura90系列新
AMD砸67亿入股Meta!首批Helios系统已安装测试
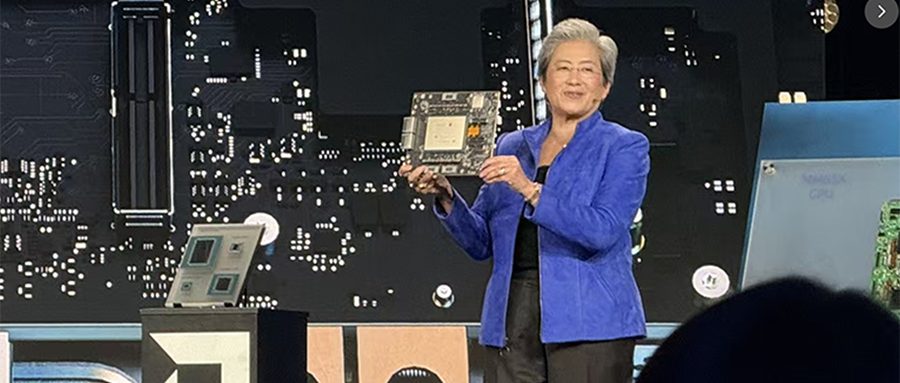
智东西 编译 | 孙小雯 编辑 | 程茜 智东西10月28日消息,昨日,AMD宣布将出资认购Meta新发行的股票, 投资金额为10亿美元(约合人民币67.2亿元) 。其同时披露,首批Helios机架级AI计算系统已在Meta安装并开展测试,两家公司将继续扩大芯片、计算系统和软件合作,支持Meta旗下模型及AI服务。 Helios将GPU、服务器CPU、网络设备及配套软件整合在同一机架中,用于大模型训练和推理。今年2月,双方已宣布长期合作,Meta计划采用AMD GPU建设 最高6吉瓦规模的AI计算基础设施 。 目前,Meta正在建设四个容量分别超过1吉瓦的超级计算集群,计划于今年内将基础设施总
空气动力学、碰撞都能模拟:谷歌Genie 4来了,把物理写进世界模型!
智东西 编译 | 杨京丽 编辑 | 李水青 智东西10月28日消息,今日,谷歌发布新一代世界模型Genie 4。该模型具备更强的 真实感和实时交互能力 ,能够在生成世界的同时, 原生生成音乐、环境音和交互式对话 。 ▲谷歌发布最新世界模型Genie 4(图源:X) 谷歌称,Genie 4 融合了Gemini系列模型的能力 :Gemini Omni负责让模拟环境 在外观和行为上贴近现实世 界,其他Gemini模型则提供复杂 推理能力 ,帮助模拟世界保持连贯性和连续性。 用户可以在Genie 4中启动事件,模型会模拟事件发生后的过程,包括世界如何响应、环境如何发声,以及其中的人物如何移动、反应和说
数种声源混叠也能精准解析!科大讯飞亮出语音基座大模型SparkAudio 1.0
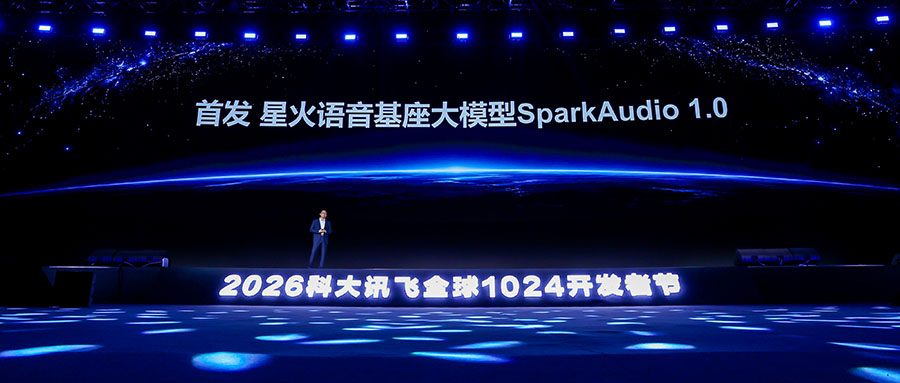
智东西 作者 | 程茜 编辑 | 漠影 如果让你扮演一名刑侦助手,你能从下面数种声源混叠的音频里分析出受害人的所在位置吗? document.createElement('audio'); https://oss.zhidx.com/740757fa9b8419b7de91ddcfa969f263/6ae21c00/uploads/2026/10/6ae18c1fde699_6ae18c1fd995f_6ae18c1fd992b_%E9%9F%B3%E9%A2%91%E7%89%87%E6%AE%B51.wav 讯飞最新发布的语音基座大模型 SparkAudio 1.0 ,在几秒内就给出了答案