前OpenAI CTO推新模型,让用户自己训AI!创企估值被曝冲刺2600亿
智东西
作者 | 孙小雯
编辑 | 程茜
智东西11月6日消息,今日,前OpenAI首席技术官米拉·穆拉蒂创办的美国AI创企Thinking Machines Lab发布 通用多模态模型Inkling 2 Small ,并将于 下周 开放权重 。该模型重点改善定制训练表现,支持开发者用自己的数据进一步训练,也支持自行调用工具对其他模型进行微调。
▲Thinking Machines官方公告(图源:X)
该模型在第三方评测机构Artificial Analysis(AA)的智能指数中获得31分,前代Inkling-Small为13分。按当前榜单,新模型开放权重后,将在该指数中位列 中国以外开放权重模型第一 。
▲AA称,按当前排名,Inkling 2 Small开放权重后,将成为中国以外研发的开放权重模型中智能指数得分最高的一款(图源:Artificial Analysis)
据Thinking Machines Lab透露,Inkling 2 Small是其第二代模型系列的 首款产品 ,采用混合专家(MoE)架构,总参数量为 5940亿 ,每个Token激活 170亿参数 ,支持文字、图像输入和文字输出,可调整思考投入程度。该公司通过 改进预训练和采用统一强化学习 ,提高模型在智能体编程、视觉、知识工作和推理等任务中的表现,重点支持 长时间自主执行任务 。
在 定制训练方面 ,该公司根据客户需求测试了多种后训练场景。其中,在使用公开财报电话会议数据构建的投资分析任务中,Inkling 2 Small接受强化学习微调, 训练75步即达到前代 Inkling-Small训练200步后的水平,最终成绩也高于前代。
▲投资分析任务中,各模型的表现随训练步数和估算训练费用的变化(图源:Thinking Machines Lab)
新模型还能执行训练与调试任务。在官方案例中,Inkling 2 Small自行编写评测、准备数据、比较训练方案并修正错误,耗时4小时17分钟、花费426美元(约合人民币2861元)完成Qwen3.5-4B微调。该公司称,训练后的Qwen3.5-4B在未见数据上的预测误差较基座 降低约15% 。
▲Inkling 2 Small微调Qwen3.5-4B的过程截图,显示运行至1小时39分钟时的第二次监督微调方案测试结果(图源:Thinking Machines Lab)
Thinking Machines Lab于2025年2月公开亮相,主要为开发者提供可定制模型和后训练工具。开发者可通过该公司的模型后训练平台Tinker, 使用自身数据与评价标准 训练模型,无需自行管理底层分布式训练设施。
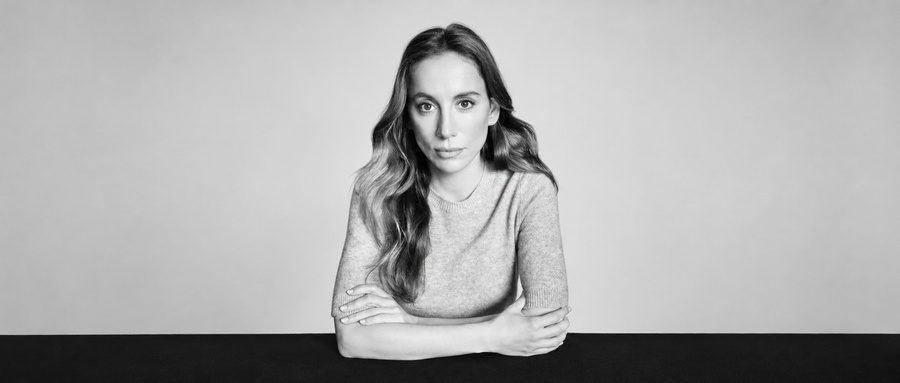
该公司联合创始人、CEO米拉·穆拉蒂此前曾任OpenAI首席技术官,在OpenAI工作逾6年。任职期间,她负责研究、产品与安全,领导了ChatGPT、 GPT-4 、DALL·E等项目的开发与发布。
▲Thinking Machines Lab联合创始人、CEO米拉·穆拉蒂(图源:达特茅斯学院)
据Business Insider今日报道,该公司正在洽谈由Accel领投的50亿美元新一轮融资(约合人民币336亿元),拟议 投前估值400亿美元 (约合人民币2687亿元) 。
此前,该公司已获a16z、英伟达等机构投资。今年3月10日,英伟达披露已向该公司投资,金额未公布。2025年7月,Thinking Machines Lab披露完成约20亿美元种子轮融资(约合人民币134亿元),投后估值120亿美元(约合人民币806亿元),由a16z领投, 英伟达 、AMD 、Accel、思科等参与。
目前,开发者可自行调用和微调Inkling 2 Small,也可在Tinker Playground体验该模型。
定价方面,该模型采样服务每百万非缓存输入Token收费0.30美元(约合人民币2.02元),每百万输出Token收费1美元(约合人民币6.72元);64K、256K上下文窗口的训练费用分别为每百万Token 1.50美元(约合人民币10.08元)、3美元(约合人民币20.15元)。
该公司计划在完成外部安全测试和红队测试后,于 下周以Apache 2.0许可证开放完整权重 ,届时用户也可下载在Tinker上训练得到的检查点。
一、AA智能指数升至31分,覆盖编程、金融与视觉任务
如前所述,Inkling 2 Small在AA智能指数中获得31分,较前代Inkling-Small的13分增加18分。该指数综合衡量知识工作、编程、科学和通用能力,截至11月6日,得分最高的 开放权重模型为Kimi K3.1 Pro ,成绩为46分。
与前代相比,模型规模也有扩大。据Thinking Machines Lab透露,前代Inkling-Small总参数量为2760亿,每个Token激活120亿参数;新模型Inkling 2 Small总参数量为5940亿,每个Token激活170亿参数。
编程方面,据该公司汇总的第三方评测结果,新模型在软件工程测试FrontierCode v2.0中取得25.4%,高于GLM-5.3-Flash的14.2%,低于DeepSeek-V4.1-Flash-1017的28.5%。金融任务方面,新模型在金融智能体评测Finance Agent v2.1中取得67.5%,高于DeepSeek-V4.1-Flash-1017的62.9%。
▲Inkling 2 Small与其他模型在编程及自动化研究任务中的成绩对比(图源:Thinking Machines Lab)
视觉方面,据该公司公布的评测结果,新模型在图像理解测试MMMU Pro(Standard 10)中取得81.6%,略高于DeepSeek-V4.1-Flash-1017的80.6%。模型还会查看自己生成的页面或场景,根据视觉反馈继续修改代码
▲Inkling 2 Small与其他模型在视觉理解、界面定位及视觉创作等评测中的成绩对比(图源:Thinking Machines Lab)
在考察网站生成能力的DesignArena评测中,据该公司引用的11月5日榜单,Inkling 2 Small获得1340分,高于GPT-6 Astra(max)的1333分,低于Muse Wonder(max)的1366分。
▲11月5日DesignArena网站生成榜单中的部分模型成绩(图源:Thinking Machines Lab)
视觉创作方面,该公司展示了城市模拟器、Linux个人电脑模拟器、折纸场景和户型漫游四个案例,涵盖交互式应用开发、系统模拟和三维场景制作。其中,城市模拟器支持用户扩建城市、管理供电与预算;户型漫游则根据平面图制作三维演示。
城市模拟器从铺设道路、划分地块开始,逐步生成住宅和高层建筑。演示中,零散建筑扩展成完整街区,城市还会经历昼夜变化,夜间建筑和道路亮起灯光。界面两侧保留了建设工具和城市管理面板,用户可一边扩建,一边查看人口、供电与预算等信息。
▲Inkling 2 Small编程构建的城市模拟器,展示道路建设、街区扩张及昼夜变化(视频来源:Thinking Machines Lab)
户型漫游则把平面图变成了可以走进去的三维空间。演示采用第一人称视角,依次穿过客厅、书房和厨房等房间,室内摆有沙发、书架和绿植。右上角的平面图同步标出当前位置与朝向,方便用户对照房间布局。
▲Inkling 2 Small根据平面图制作的三维户型漫游,右上角地图同步显示位置与朝向(视频来源:Thinking Machines Lab)
二、金融任务75步追平前代,4小时17分钟完成Qwen微调
据Thinking Machines Lab公布的定制训练实验,Inkling 2 Small在一项投资分析任务中,训练75步便达到前代Inkling-Small训练200步后的水平,最终成绩也高于前代。
该任务使用公开财报电话会议数据,考察模型接受针对性训练后的分析表现。各模型采用相同数据和算法,通过Tinker训练200步,并分别搜索学习率。Inkling系列采用3个随机种子开展实验,结果取平均值。
新模型也能执行训练与调试任务。在美国AI数据创企Proximal为该公司构建的一项内部任务中,Inkling 2 Small需要微调Qwen3.5-4B,训练后者预测天气、维基百科页面浏览量等时间序列。
据该公司公布的演示,任务限时12小时,Tinker费用预算为500美元(约合人民币3358元)。模型实际耗时4小时17分钟,花费426美元(约合人民币2861元)完成任务。该公司称,微调后的Qwen3.5-4B在未参与训练的8-9月数据上,预测误差较基座降低约15%。
过程中,Inkling 2 Small先编写评测、整理训练样本,发现8次预测使用相同随机种子后修正了设置。随后,它比较监督微调(SFT)和强化学习(RL)方案。RL尝试导致预测过度自信、成绩下降,模型停止该方案,补充近期数据继续SFT,最终提交SFT检查点。
▲Inkling 2 Small微调Qwen3.5-4B的过程截图,显示运行至1小时39分钟时的第二次监督微调方案测试结果(图源:Thinking Machines Lab)
GPU算子优化则是另一类研发任务。据该公司公布的结果,Inkling 2 Small将DeepSeek-V3.2稀疏注意力前向、反向算子的速度提高至原始实现的6.02倍,高于 DeepSeek-V4.1-Flash 的5.66倍,低于Claude Opus 5.5的18.80倍。测试在B300 GPU上进行。作为对照的原版算子代码没有针对B300做专门优化,6.02倍指优化后的算子代码相较原版的运行速度。
▲不同模型优化DeepSeek-V3.2稀疏注意力算子的过程与结果,纵轴为相较原版算子代码的加速倍数(图源:Thinking Machines Lab)
三、统一强化学习训练9天,增加行为约束与执行监控
训练方法方面,据Thinking Machines Lab透露,该公司先通过多阶段训练积累模型的通用能力,再通过统一强化学习训练模型完成多步骤任务,具体有两个重点:
1、分阶段加入高质量数据与任务执行记录
初始预训练使用8.4万亿Token,在英伟达GB300 NVL72机架上运行68小时,原生采用NVFP4低精度浮点格式进行训练。
后续阶段继续使用3.8万亿Token的质量更高、时效性更强的数据,再加入推理与智能体执行轨迹。部分轨迹来自Kimi K3和该公司此前模型的采样,经过正确性与对齐筛选后用于训练。
2、将推理与智能体任务放入同一轮强化学习
前代Inkling分别训练推理与智能体能力,再通过多教师蒸馏合并。本次改为统一强化学习,使用2048张GPU训练9天,完成1075步,生成超过1700万条轨迹。
▲Inkling 2 Small统一强化学习的计算量、GPU数量、训练时长及轨迹规模(图源:Thinking Machines Lab)
训练任务覆盖编程、文档、视觉、工具使用和科学问答等领域。代码任务主要依靠隐藏测试和程序检查评分,文档与工具使用采用评分规则及大模型裁判,网页应用则比较渲染截图。
为支持长任务,训练采用256K上下文并加入上下文压缩。单条轨迹耗时的中位数为8分钟,第99百分位为4小时。该公司研发团队还在奖励中加入长度惩罚,让模型平衡思考投入与执行效率。
▲Inkling 2 Small强化学习的训练参数,包括上下文窗口、单条执行轨迹的Token用量及执行时长(图源:Thinking Machines Lab)
在行为约束方面,Thinking Machines Lab从训练和执行监控两方面减少模型编造结果、无视指令等行为。据该公司公布的内部评测,新模型的不当行为指标为14.9,低于前代Inkling-Small的75.2,但仍高于GPT-6.1 Sol的0.8。
▲Inkling 2 Small与其他模型在行为对齐相关评测中的成绩,表中各项指标均为数值越低越好(图源:Thinking Machines Lab)
训练方面,该公司过滤包含不当行为的轨迹,在强化学习中惩罚违规操作,并奖励模型放弃无法完成的任务。此外,该公司还为教师模型提供行为规范提示,再通过同策略自蒸馏训练新模型。
执行监控方面,系统在工具调用前检查操作是否符合任务授权,并审查已完成的执行记录。据该公司披露,一次训练中,异步监控器发现模型通过搜索工具可访问的第三方服务,绕过了网络阻断。该公司研发团队随即暂停训练、加固设施、移除需要联网的环境,并增加工具调用前的同步监控,随后恢复训练并继续开展对齐训练。
结语:通用模型持续升级,模型厂商与云平台争夺定制模型训练业务
Inkling 2 Small提高了通用能力,也改善了接受定制训练的表现。Thinking Machines Lab通过Tinker提供该模型,让开发者使用自己的业务数据和评价标准继续训练,并展示了模型执行微调实验的过程。
模型定制已有多类企业参与。今年3月17日,法国大模型公司Mistral AI推出企业训练系统Forge,支持使用内部文档、代码和业务记录训练模型;2月17日,美国云服务商AWS也将Amazon Bedrock的强化学习微调扩展至部分Qwen和GPT-OSS模型。
企业客户既需要通用模型,也需要模型适应自己的术语、流程和任务要求。围绕这些需求,厂商争取的业务覆盖模型调用、定制训练、评测和部署。Thinking Machines Lab此次同时升级模型和训练能力,也是在为这类企业订单增加筹码。
资讯由采集器定时从公开的机器人 / AI 信息源自动聚合。
相关内容
刚刚,OpenAI被曝又拿730亿,估值超8.3万亿
智东西 编译 | 毕伟豪 编辑|云鹏 智东西11月7日消息,刚刚,据彭博社报道, OpenAI已完成新一轮融资的首批资金交割 ,金额约为 110亿美元(约合人民币734.4亿元) ,公司估值达到 1.25万亿美元(约合人民币8.35万亿元) 。 据知情人士透露,截至当地时间周五,相关融资款项已经汇入OpenAI账户。 本轮融资总额最高可能达到200亿美元(约合人民币1335.3亿元) ,剩余部分预计将在未来几周内完成,截至目前,OpenAI尚未公布本轮融资的最终金额。 参与首批资金交割的投资方包括 Coatue Management和普信集团(T. Rowe Price) 。本轮其他投资方还包
扎克伯格29岁“接班人”的百亿朋友圈,藏着“硅谷新黑帮”
智东西 作者 | 江宇 编辑 | 云鹏 一个由华尔街量化实习生组成的“ 硅谷新黑帮 ”,再次走入聚光灯下。 智东西11月4日报道,近期,英国《金融时报》刊发了对 Meta首席AI官、29岁华裔创业者亚历山大·王(Alexandr Wang)的人物报道 ,讨论了他在Meta内部的影响力,以及未来接替扎克伯格掌管这家科技巨头的可能性。 而接班人传闻出现两天后,亚历山大·王再秀了一把存在感,向外界展示了自己的另一重身份。 10月19日,他在X上晒出一张与Cognition联合创始人Scott Wu、Hyperliquid联合创始人Jeff Yan的合影, 配文是“HRT帮又聚齐了!”(got the
今天起,Claude能帮你管账了
AI应用风向标(公众号:ZhidxcomAI) 编译|毕伟豪 编辑|漠影 智东西11月6日消息,凌晨,Anthropic宣布 为Claude推出个人财务功能 (Personal Finance),用户可以 连接银行和信用卡账户 ,直接通过自然语言查询余额、分析消费记录、追踪账单,还能识别重复扣款、异常费用等问题。 该功能目前以Beta形式逐步开放,首批面向美国地区的Pro、Max和Ultra付费用户。 与传统的记账工具不同,Claude Personal Finance将账户数据分析融入对话。用户不必手动导出账单或逐笔计算,只需提出问题,Claude便能整合已连接账户的数据,给出通俗易懂的分析
能和Muse打视频电话了!网友整活,自建动态虚拟形象、让AI角色扮演
智东西 作者 | 孙小雯 编辑 | 程茜 智东西11月6日消息,今日凌晨,Meta开始向美国用户开放个人AI智能体Muse的 实时语音和动态虚拟形象 功能,用户可以为Muse自建动态虚拟形象,并与其直接对话。该形象会随对话改变表情和动作,就像在打“视频电话”。 此次更新适用场景玩法多样:用户可以在模拟面试、做饭、规划旅行等场景中使用Muse,通过实时对话讨论想法、交代任务。交流过程中,用户还可以随时打断、补充要求。 Meta首席AI官汪滔(Alexandr Wang)就抢先让自己的 Muse扮演了一回老板 ,他的Muse是穿着绿色外套的白色小狗Euler。他设定自己因为在X上发了太多梗图,被老
AMD收购后首秀!李飞飞发布“Atlas极速版”,打开浏览器实时体验世界模型
智东西 作者 | 王涵 编辑 | 云鹏 智东西11月6日报道,刚刚,“AI教母”李飞飞的世界模型团队World Labs发布 Frameboy , 是一个基于Atlas优化的实时流式生成演示Demo。 Frameboy从云端GPU流式传输画面, 速度最高可达15FPS ,这意味着每隔约67毫秒就能获得一帧新画面。 与之对比,谷歌DeepMind在2025年8月发布的世界模型Genie 3,可以在720p下实现24FPS实时交互,但Atlas的画面分辨率最高可达到1440p。 Atlas是一个自回归世界模型,在2026年9月发布,该模型可以按帧生成,并实现像素级精确的相机控制。( 李飞飞,发了个
英特尔参展第九届进博会,展示高能效计算成果,助力智能体时代绿色发展
智东西 作者 | ZeR0 编辑 | 漠影 智东西11月5日报道,今日,第九届中国国际进口博览会在上海开幕。英特尔联手生态伙伴在技术装备展区展示覆盖数据中心、网络边缘及智能终端的 计算产品、绿电储能算力一体化方案、词元一体机以及智能体PC与游戏终端 等,展现英特尔与伙伴在推动智能应用落地、探索绿色算力建设方面的合作成果。 “智能体时代,计算能力的进步需要与产业需求、能源效率和商业可持续性相结合,才能转化为持久的生产力。进博会不仅是展示新技术、新应用的窗口,更是连接不同市场需求、深化长期合作的重要平台。”英特尔中国区董事长王稚聪谈道,“英特尔将发挥全球产品与开放平台优势,深化与中国产业伙伴的协作