打破“算力存储通信”三堵墙,昇腾超节点给出十万亿大模型训推“最优解”
智东西
作者 | 云鹏
编辑 | 漠影
如果说2026年的AI圈只有一个关键词,那必然会是 “智能体(Agentic AI)”。
从能聊到能干,智能体浪潮下,AI在各领域开始加速赋能,AI编程的爆发进一步带来生产力的质变,在各行各业掀起变革。
随之而来的是AI推理需求呈指数级爆发, 2030预计全球每月Token消耗数将超过120千万亿,暴涨24倍。
为了支撑更强的Agent处理更复杂的任务,模型也越来越大,顶级MoE模型参数量直接来到“十万亿级”,训练压力同步增长。
既要支持更大规模模型高效训练,又要在推理端支持更长上下文,实现更低时延、更低成本、更高效率,这样的需求传统服务器难以应对, “超节点”逐渐成为AI基础设施领域行业公认的更优解决路径。
理想状态下,大量AI加速器紧密耦合成为一台更高密度的AI计算单元,超节点可以解决大模型训练和推理中的 “存储墙”和“通信墙”。
但理想很丰满,现实很骨感,超节点落地需要克服诸多挑战。全球芯片巨头、云厂商、服务器大厂争先发布“超节点”产品,但真正商业化落地的很少。
如何真正突破集群内计算、存储等各类资源的通信瓶颈?如何真正通过系统性架构创新优化,实现全域资源统一高效调度?让成千上万张计算卡像一台计算机一样高效运转,绝非易事。
自今年WAIC上真机亮相后,昇腾950超节点备受业内关注,近日在华为全联接大会2026期间正式上市,成为了 业界最大规模的商用超节点。
▲华为全联接大会2026昇腾展区
继去年昇腾910C超节点发布首次将“超节点”带入行业视野、引领行业向超节点方向前进后, 昇腾为何能成为业界最大规模商用落地超节点?从技术验证迈入规模化商用落地攻克了哪些关键挑战、为何昇腾950超节点能成为当前万亿模型训推的最佳选择?
或许正如华为昇腾计算产品线总裁张迪煊在演讲中所说,大模型每一波迭代都带来新的AI需求,而昇腾超节点用大带宽、低时延和内存统一编址的确定架构,来应对AI变化的不确定性。
▲华为昇腾计算产品线总裁张迪煊
让超节点真正大规模落地,昇腾先交卷了
一、让千卡像“一台计算机”一样运行背后:硬核技术创新与工程化落地缺一不可
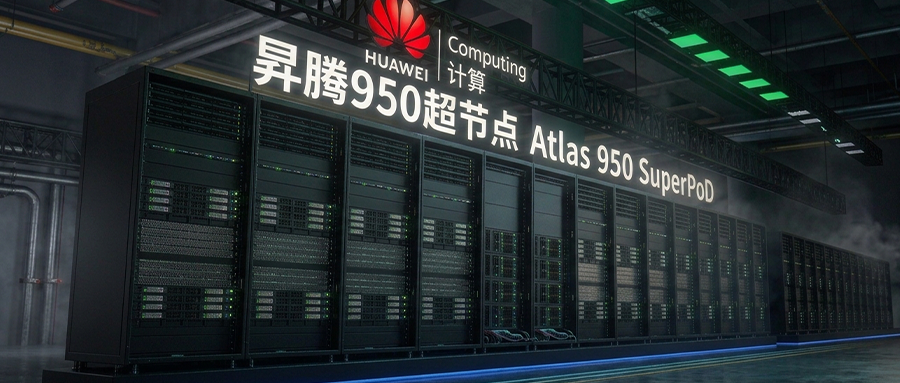
此次上市的昇腾950超节点包括Atlas 950 SuperPoD液冷超节点和Atlas 850E风冷超节点,两者场景各有侧重,基于各自核心技术升级点,很好地解决了AI时代不同场景、不同类型企业在解决AI基础设施建设中所面临的一系列挑战。
Atlas 950 SuperPoD液冷超节点, 1024颗高性能NPU、1300多个灵衢互联套片、4000多个光模块和19万根CableTray,让千张卡像一台超级计算机一样协同工作, 是一个极为复杂的系统性工程。
纵观市面上的超节点产品,昇腾950超节点能够率先规模化商用落地,原因不难分析,但极难模仿:
首先是 极强的技术领先性 ——基于强大的技术力,突破既往行业中很多关键技术瓶颈;其次是 扎实的工程化落地能力 ——深耕AI基础设施、懂场景懂客户懂痛点,把超节点落地中每一个细节都做到位, 让客户不是只能“感觉好、用不上”,而是真正能“用得上、用得好”。
以Atlas 950 SuperPoD液冷超节点为例,从技术创新角度来看,其在 芯片和互联 两个层面都实现了突破。
在芯片微架构创新方面,其重点提升算子开发易用性和效率,过去需要开发者手动管理的数据搬运、格式转换、通信同步、缓存策略,都下沉到硬件里,写代码更简单,开发效率更高。
互联层面, 灵衢高速互联技术 发挥着关键作用,统一的互联协议实现1024卡统一内存编址,让跨卡远程内存访问就像操作本地内存,芯片互联带宽相比上代提升2.1倍,给超大模型的高频通信提供了保障。可以说灵衢互联成为了打破通信瓶颈的“高速路”。
当然,还有不少“黑科技”我们不再一一枚举,同样值得注意的是Atlas 950 SuperPoD液冷超节点在工程化落地层面的创新。
昇腾自研的TPSU电源模块可以提供储能能力,进而支撑训练推理业务供电波峰诉求。
散热方面,高性能昇腾950 NPU单个模组有950W功耗,昇腾通过高密铲齿+冰川铠甲冷板技术,以及多水路串联设计, 单块冷板就能带走2000W的热量, 提高单位空间散热效率。
正交架构设计 也是亮点之一,其实现了柜内零线缆全电互联,单柜就可以减少6000多根线缆,一个1024超节点可以省下50千米的铜线,在根除线缆老化与故障风险、大幅提升系统可靠性、降低时延的同时,实现了资源的节省。
此外,柜间光互联使用了业界唯一的 光模块液冷技术, 在时延降低的同时,一个超节点4000多个光模块所节省的电力消耗相当于数千户家庭的年用电量。链路级重传技术、2+2光模块保护技术则攻克了“超节点光模块易闪断”的行业顽疾,保证了超节点的可靠性、支撑超节点规模扩展。
我们看到,基于海量技术创新和扎实的工程化落地突破,昇腾950超节点真正实现了 计算、存储、通信三大系统高效协同打通,让整个超节点系统具备落地的基础,而非徒有“性能参数”的空中楼阁。
最终在实际大模型训推场景中,Atlas 950 SuperPoD形成了相比行业其他解决方案突出的领先优势。
训练侧,其训练效率有着1.5-1.7倍提升,基于器件、网络、系统三重可靠设计,实现了 万卡超节点集群实现月级稳定训练。
推理侧,昇腾超节点在中心高并发推理场景中可以实现低时延、高吞吐推理,推理 性能2-3倍提升、时延低于10ms, 实现万亿模型训推一体化。
值得一提的是,昇腾是 国内唯一商用支持mxFP8低精训练和全流程支持mxFP4推理的厂商。
一系列优势特性令昇腾迅速得到行业认可,今天,昇腾超节点已经广泛应用于互联网、运营商、金融、教育、医疗、交通、制造等行业。
在峰会现场展区,我们看到在昇腾超节点加持下,蚂蚁阿福的模型训练实现了“离线持续优化、在线实时纠偏”的能力,场景实际响应、吞吐大幅提升,最终让健康AI服务响应更快、解读更精准;德赛西威则基于昇腾超节点构建高性能算力底座,训推性能超过业界GPU平台。
昇腾超节点进一步推动了Agentic AI和AI编程规模化落地, 证明了“超节点”这一形态的可行性、极强的应用潜力,从技术和工程化落地层面给行业树立了蓝本, 让行业可以基于超节点规划和建设万亿模型的算力基础设施。
十万亿级大模型训推的阶段性“最优解”,被昇腾950超节点拿下了。
二、从液冷数据中心走向企业级风冷机房,无需改造直接部署,直指AI推理核心痛点
相比面向液冷数据中心的Atlas 950液冷超节点,Atlas 850E风冷超节点则更加聚焦企业级通用风冷机房的超节点升级改造。
这款产品背后体现的 对行业用户痛点、场景需求的精准洞察,在工程化落地过程中攻克的一系列细节难题, 都是超节点能够真正率先实现规模化商用的关键,是昇腾超节点的核心差异化优势之一。
纵观行业,大量企业级通用风冷机房面临液冷基建改造周期长、成本高的现实门槛,制约了超节点技术的规模化普及。而 Atlas 850E风冷超节点 基于自研相变散热技术,无需对现有风冷机房做液冷改造,标准风冷机柜可以直接上架部署,支持从32卡到768卡。
无需改造直接把超节点技术部署到传统机房, 这在过去是企业“想都不敢想”的。
在企业级推理场景中,Atlas 850E风冷超节点原生覆盖FP8、mxFP8、HiF8、INT8、mxFP4全量低精格式,可以稳定实现10ms级时延推理。
对于Agent多轮对话、高频KV缓存读写负载等需求需求,其都能很好地满足,支持多卡高效并行推理和内存资源池化。
在实际场景中,通过超节点的异构PD分离方案根据业务负载动态调整PD配比、叠加大规模专家并行优化,最终Atlas 850E风冷超节点在万亿参数MoE模型推理上实现了 5-10ms的极致低时延, 单卡吞吐比业界风冷集群提升 2.5倍。
Atlas 850E风冷超节点的商业规模化落地,让更多场景的客户有了新的选择,尤其是对于中小企业级场景客户来说,解决了他们最为关心的迁移成本、迁移效率等问题。
让超节点从液冷数据中心走向更广泛的通用风冷机房, 让更多企业可以高效、低成本地实现Agentic AI推理业务规模化落地,昇腾做到了。
三、软件系统给硬件装上“强大脑”,昇腾开放生态加速成长
超节点夯实底层算力基础,上层昇腾软件生态的茁壮成长则进一步释放昇腾潜力,让超节点更快落地千行万业,实现赋能。
如果说 硬件是把算力“拧成一股绳”系统软件就是统一调度的“大脑”,完善的软件生态是昇腾从“算力强大”走向“好用易用”的关键。
昇腾超节点的系统软件包括灵衢总线管理、灵衢系统服务以及超节点管理等组件。其中灵衢系统高阶服务支持跨物理节点统一内存编址,编程模式和执行模型与单系统语义一致,支持实现超节点域内的Load/Store内存语义访问。
基于内存语义和拓扑编排等技术,1024卡超节点域内集合通信性能提升1.6倍。实测中,在大EP的跨卡通信场景,1K小包通信,耗时从70微秒降到8.6微秒,性能提升8倍。
可以说,昇腾超节点系统软件,基于高性能、高可用核心能力,充分释放了超节点的算力潜能。
最后,昇腾软件生态的开源开放也进一步加速着昇腾超节点在各领域的落地,从 各个环节深度赋能开发者。
去年,昇腾完成了CANN和Mind系列的全面开源开放,这是昇腾生态迈出的重要一步,全面开源开放、兼容主流生态,让昇腾的易用性进一步提升,对开发者们来说, AI开发从“专家专属”走向了“人人可用”。
如今CANN社区月活开发者突破5200多名,位列 中国开源项目活跃度排名第一。
从入门部署、算子开发、训练推理到性能调优,昇腾从全流程帮助开发者,智能体时代,Agentic覆盖整个链路,进一步让编程和创新变得更简单。
昇腾软件生态让昇腾 从“好用”迈向“易用”, 每个开发者都能充分利用昇腾优势,落地优秀AI应用。
结语:从行业首发到规模落地,昇腾重塑Agent时代算力底座
面对行业超节点 “只见产品发布、不见商业落地” 的困局,昇腾一手紧握底层技术架构创新领先、一手紧握扎实工程化落地能力,系统性地解决了超节点实际落地过程中的一系列“卡点、难点”,让超节点不再是纸面好看部署困难,而是真正能用、好用、易用。
而液冷、风冷双形态,则实现了 全场景覆盖, 让更多中小企业以低门槛享受到超节点带来的优势。
可以说,昇腾超节点就像班中的模范生,在这场AI剧变时代的算力基建大考中,率先交卷了,为十万亿级大模型时代AI基础设施建设树立了新标杆。
从昇腾落地的路径中我们也不难看出, 未来超节点竞争的本质是“硬件架构+系统工程+软件生态”的综合考验, 基于技术和生态飞轮,先发者的优势或进一步扩大。
无论如何,AI掀起的算力变革已经开始,而 昇腾的“硅基黑土地”,正试图为AI无处不在、充满不确定性的未来提供一种更坚实、更确定的选择。
资讯由采集器定时从公开机器人 / AI 信息源自动聚合。
相关内容
除了更贵的订阅和砍半的额度,OpenAI 想做的还是「微信」
模型越来越便宜,付费给的用量却砍了半 作者|Alan 北京时间 9 月 30 日凌晨,OpenAI 开完了它口中「迄今规模最大的一届」开发者大会。官方汇总页上一共列了 25 项发布,从新模型、新 API,一路排到给企业买软件用的应用市场。 现场最安静的一刻,出现在 Sam Altman 讲到 ChatGPT Pro 会员调整的时候。台下没有一个人鼓掌。 调整本身不复杂:每月 200 美元的 Pro 200 价格不变,新订阅的用量缩水;另外新增一档 Pro 500,每月 500 美元,用量是 Plus 的 25 倍,外加一个个人套餐里只有它能用的提速档 Astra Ultrafast。 那一阵沉
刚刚,iQOO掏出年度旗舰,自研电竞芯片性能提升15%,首款电竞平板也来了
智东西 作者 | 陈骏达 编辑 | 心缘 智东西9月29日报道,刚刚,vivo旗下iQOO品牌发布了年度旗舰手机iQOO 16,这台手机搭载了第六代骁龙8超级至尊版,全球首发了由iQOO和三星显示联合研发的2K 165Hz三星珠峰屏,并基于iQOO搭建的“3+2游戏技术版图”,提升了手机在视效、操控、直播和跨端游戏等维度的体验。 同时,iQOO还发布了其首款电竞平板iQOO Pad Ultra,这款产品同样采用第六代骁龙8超级至尊版,并搭配iQOO自研电竞芯片Q4和全新一代Monster超核引擎,还通过五重风冷散热系统、新一代超感触控引擎和自研Q-flex操控技术提升游戏体验。 先来看iQOO

刚刚,DeepSeek Harness桌面端上线,梁文锋开送Token了
智东西 作者 | 江宇 编辑 | 漠影 智东西9月29日报道,今日, DeepSeek正式推出DeepSeek Harness v0.2预览版 ,并提供开箱即用的macOS和Windows 桌面端 安装包。 ▲DeepSeek Harness v0.2预览版界面 用户前往DeepSeek Harness官网下载安装后,按照引导即可直接使用,无需再自行配置开发环境。 这是DeepSeek Harness自8月13日晚推出开发者预览版v0.1并同步开源后的又一次重要更新。 此次v0.2进一步补齐了 桌面端产品体验 ,不仅 预置日常办公和开发中的常用功能 ,还新增 插件安装与管理页面、自动化任务 等
AMD 82 亿美元收购 World Labs,买的不只是世界模型
9 月 3 日,英伟达宣布以约 130 亿美元收购 Hugging Face。25 天后,AMD 宣布以约 82 亿美元收购李飞飞创办的 World Labs。 两笔交易放在一起看,更觉得有意思。CNBC 最新的报道提到,Hugging Face 在被英伟达拿下之前,AMD 和 Salesforce 都曾表达过收购兴趣。 没抢到 AI 世界里最大的模型「集散地」,AMD 转身买下了一支造模型的顶级团队。 根据 AMD 的公告,这是一笔全股票交易 ,预计在 2026 年底前完成交割,仍需通过监管审批。交割之后,李飞飞将出任 AMD 执行副总裁兼首席科学家,直接向 CEO 苏姿丰汇报。 这也是 A
让Token像土豆一样便宜,要闯哪四关?
进入2026年下半年,全球算力涨价潮持续发酵。 “让全世界更多的人,像享受土豆一样,享受Token。” 9月19日,央视《对话》走进远景乌兰察布星河基地,远景科技集团创始人张雷用这个比方,提出了一个看似简单的问题: AI怎样才能更普惠? 这句“AI土豆论”很快在算力圈引发讨论,背后是全行业共同的成本焦虑: AI算力的门槛,实在太高了。 就在节目播出三天后,小米发布MiMo-V2.6,并公开了全程直播的“炼丹”账本,把这份昂贵具象化:MiMo-V2.6的Pro与Flash两个版本,仅强化学习后训练阶段就跑了不到6天,合计烧掉了 347万美元 , 约合人民币2344万元 。 这还只是后训练环节。据
Anthropic 招股书里,最耐人寻味的 7 个细节
作者|Techno 之王 编辑|靖宇 当地时间 9 月 28 日,外媒披露了一份 Anthropic 的 IPO 招股书。 先要说清楚这份文件的性质。它并不是 Anthropic 主动公开的版本。今年 6 月,Anthropic 以公益公司身份向美国证交会秘密递交了 S-1 注册声明草案,为普通股首次公开发行做准备。按照规则,公司要在向机构投资者路演前至少 15 天公开递交修订版 S-1,完整财务数据到那时才会被外界看到。路透此次看到的是一份尚未公开的版本, Anthropic 对此拒绝置评 。 这意味着其中的数字仍可能随证交会的审阅意见调整,不少细节也只能通过路透的转述窥见一角。 但如果这份