GPT-6.1 Sol极速版快8倍,但依然口碑秒崩?“变相涨价”被网友怒喷
智东西
作者 | 毕伟豪
编辑|云鹏
智东西10月9日报道,在重置之神Tibo“ 连续28天新发布或者重置 ”的第四天,OpenAI改进了转向功能并发布了GPT-6.1 Sol的Ultrafast(极速)模式, 智能接近Astra,速度比标准版GPT-6.1 Sol快8倍 。
速度快了, 价格自然也是水涨船高 ,现阶段,GPT-6.1 Sol按照速度分三档售卖,标准版价格每百万Token输入2美元,输出10美元,Fast模式速度和价格翻倍。
Ultrafast模式每百万Token输入12美元,输出60美元, 足足是标准版的6倍 。
不过,拿它与旗舰模型对比,价格又没那么难接受了。GPT-6 Astra的标准API价格为每百万输入Token 10美元、输出Token 50美元,按照相同的6倍极速定价计算,Astra Ultrafast的输入、输出价格将达到60美元和300美元, 是Sol Ultrafast的5倍 。
接近旗舰级别的智能、相比标准版最高8倍的生成速度,以及仍低于旗舰模型极速版的价格,构成了OpenAI推出这一模式的核心卖点。
但有个问题,既然Sol的能力已经接近Astra,为什么还需要专门花钱买速度?显然极速模式下的Sol价格比Astra标准版还贵点。
与此同时,Tibo本人和OpenAI的官宣贴子下方评论区,简直是大型嘲讽现场,往下随便一划,几乎看不到称赞的声音,全是“没什么用”,或者“骗子”的吐槽声。
而这些问题,背后恰恰对应着 GPT-6.1 Sol这款模型的最大痛点——速度极慢,网友实际使用中甚至仅有可怜的30甚至20tokens/s。
一、速度升级了,社区为什么意见这么大?
Ultrafast上线后,社区的反馈几乎是清一色的不满。
有用户认为,Sol标准模式的基础速度本来就偏慢,那么即使极速模式提速8倍,用户需要为Sol支付更高的价格,却未必能获得相对于其他模型足够明显的速度优势。
对于速度,还有开发者提出最重要的事情是提高标准版的运行速度,而不是发布极速版本。
还有用户指出,Ultrafast没有向Pro 200美元套餐开放,也就是说这次更新和大部分用户并不相关。
用户的大多数不满实际上是针对速度和价格之间的关系,OpenAI发布了一个便宜的龟速模型,然后通过极速模式变相涨价,这种行为引起了争议。
有开发者直接指责这就是为什么现在基础模型都很慢,都是用低价高质量来骗人的,为推出高速模式做铺垫。
这些反馈指向了一个现状,也即用户愿不愿意为速度付费,不仅取决于速度提升了多少,也取决于原本的体验有多慢,以及现有订阅权益是否足以满足需求。
这种降低基础体验然后售卖补丁包的模式,让Ultrafast模式看起来更像是营销方式而非新发布。
除了提升速度,Codex的实时纠偏功能也是今天更新的重点之一,让用户能够在模型执行任务的过程中及时介入,从而更快调整方向。
如Tibo所说,这项改进与Ultrafast结合效果会更好,有机会减少无效执行,让Agent更快走向最终结果。
这也恰好回应了社区的一部分抱怨。此前有用户反映,Sol执行任务时会长时间反复尝试,却始终无法完成工作。如果用户能及时改变任务方向,模型又能更快响应,整个工作流的效率才可能得到实质性改善。
二、能力追上旗舰,速度成了巨大短板
要理解OpenAI推出GPT-6.1 Sol Ultrafast模式的目的,还得回到GPT-6.1 Sol这款模型本身。
9月30日,OpenAI在DevDay期间发布了GPT-6.1 Sol。这款模型距离上一代GPT-6 Sol仅相隔一周,主打复杂编程、计算机操作和专业工作场景,核心卖点是以约五分之一的标准Token价格,提供接近GPT-6 Astra的能力。
从官方公布的评测结果来看,Sol确实有不小的提升。
在DeepSWE v1.1编程评测中,GPT-6.1 Sol以最高75.2%的成绩,超过GPT-6 Sol最高推理强度下68.8%的表现。
在OSWorld 2.0计算机操作评测中,Sol最高推理强度下取得71.4%的成绩,与Astra的73.5%相差2.1个百分点,单项任务成本约为Astra的七分之一。
这两项评测分别考察模型在真实代码库中完成复杂软件工程任务的能力,以及Agent在计算机上执行多步骤操作的能力。它们与Sol瞄准的实际工作场景直接相关。
当然,这些数据来自OpenAI公布的测试结果,并不意味着Sol在所有任务中都能达到Astra的水平。但至少在部分复杂工作中,Sol已经具备了以更低成本替代旗舰模型的潜力。
然而,能力提升并不意味着使用体验没有短板。
Artificial Analysis对GPT-6.1 Sol的实测数据显示,Max推理强度下,该模型生成速度仅为54.9tokens/s,简直是龟速。
社区开发者对此也是怨声载道,有开发者用动画形象对比了Claude Opus 5.5、Gemini 3.8 Flash和GPT-6.1 Sol的速度,GPT-6.1 Sol慢得可怜。
还有开发者反映,自己实际使用过程中输出速度仅有27tokens/s,建议改名叫GPT-6.1 Slow。
从用户的抱怨中,也能反映出现阶段大家关注的重点,当模型开始承担长时间编程和Agent任务时,生成速度会直接影响工作节奏。
对于普通问答,几秒钟的等待可能不算什么,但当模型需要连续生成代码、不断调用工具时,等待时间就会成为影响效率的重要因素。
按照OpenAI公布的信息,GPT-6.1 Sol Ultrafast面向对速度敏感的工作场景,包括故障调试、Agent操作应用,以及对实时响应有较高要求的交互体验等。
在这些场景中,如果更短的生成等待时间能够缩短整个任务周期,用户就可能获得更直接的效率收益。
但需要注意,官方所说的“最高8倍”指的是生成速度提升上限,并不等于所有任务都能缩短八分之七的完成时间。实际耗时还会受到推理过程、工具调用、网络延迟和任务复杂度等因素影响。
对于需要频繁调用工具的Agent应用,OpenAI也建议使用WebSocket等持久连接,以减少网络对延迟的影响。
而在价格方面,如果只看单价,Ultrafast显然不适合所有任务。对于普通代码补全、文档整理和不着急得到结果的工作,标准模式可能更划算。
但对于线上故障排查、实时应用和需要连续执行的高价值任务,速度带来的收益则可能抵消额外成本。
在Codex和ChatGPT Work中,Ultrafast目前仅面向Pro 500订阅计划、符合条件的企业用量付费计划,以及基于积分的教育版计划开放,API用户可以直接使用这一模式。
OpenAI这次推出Ultrafast模式,除了是给龟速模型提供加速器,也是将速度从模型的默认体验中拆分出来,做成一项可以付费购买的服务。
结语:是体验优化,还是营销套路?要看实际效果
OpenAI给模型能力划分了更细的价格档位,也把速度变成了一项可以单独收费的服务。
这套逻辑并不难理解。对于需要高频调用模型、执行复杂任务的开发者而言,更快的响应确实有价值。但前提是,标准版不能慢到影响正常使用,极速版也得真正带来与价格相匹配的效率提升。
尤其当AI开始承担编程、工具调用和多步骤任务时,用户买单的标准正在发生变化:模型有多聪明固然重要,能否及时响应、少走弯路并最终完成任务,同样重要。
8倍提速是一个醒目的数字,但OpenAI需要证明的,是用户多付出的成本,能否换来更高的任务完成效率。
如果做不到这一点,Ultrafast就很难摆脱“给基础体验打补丁”的质疑。
资讯由采集器定时从公开的机器人 / AI 信息源自动聚合。
相关内容
为什么灵活性是物理人工智能的真正瓶颈
机器人灵活性的下一个主要挑战是使整个系统足够可靠,以将功能转化为有用的工作。 《为什么灵活性是物理人工智能的真正瓶颈》一文首先出现在《机器人报告》上。
Agentic开发时代到来!鸿蒙PC三大原生开发工具公测,补齐国产操作系统生态关键短板
智东西 作者 | 程茜 编辑 | 漠影 当一台鸿蒙PC,既能跑鸿蒙应用,又能原生开发鸿蒙应用,会发生什么? 智东西10月10日报道,10月8日,可视化一站式IDE工具DevEco Studio、一站式鸿蒙应用AI开发工具DevEco Code与AI开发能力套件DevEco CLI,同步开启鸿蒙PC版公测。 三者分工明确:DevEco Studio主打集成开发、多端调试,承担基础IDE核心能力;DevEco Code提供端到端一站式Agentic开发体验;DevEco CLI对外输出鸿蒙开发能力,可无缝对接外部各类Agent工作流,让 AI 辅助开发融入鸿蒙 PC 原生环境。 DevEco三件套
编程体验接近Opus 5.5?谷歌Gemini 4新版本曝光
智东西 编译 | 杨京丽 编辑 | 李水青 智东西10月10日消息,今日,据外媒Business Insider报道,谷歌正在 内部测试Gemini 4的一个新版本 ,代号为 Carbon ,有望进一步缩小其与竞争对手在编程能力上的差距。 目前,Carbon已接入谷歌内部编程平台Jetski。部分员工认为,该模型的编程体验 与Claude Opus 5.5近似 ,但有员工强调,模型实际需要进行更多测试,才能作出更准确的判断。 谷歌已于10月1日发布Gemini 4 Argon ,重点面向 软件工程、企业知识工作、网络安全防御等场景 ,目前该模型尚未面向公众推出。 Carbon可能是Argon训
2026中国计算机大会定了,12位院士演讲,腾讯阿里百度、小米京东都来了
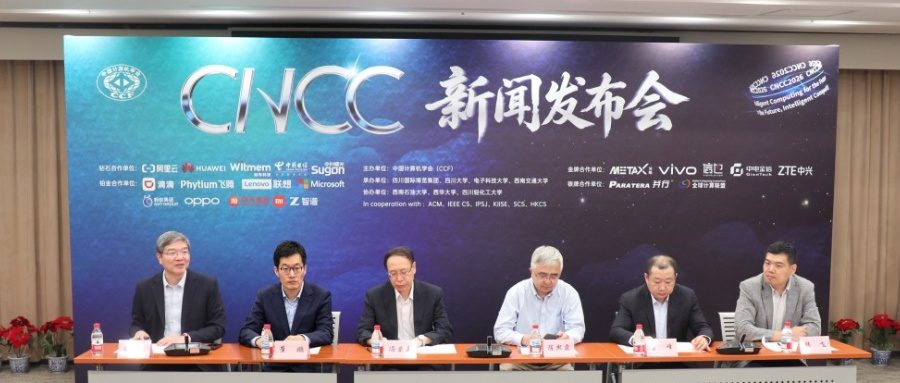
智东西 作者 | 王涵 编辑 | 云鹏 智东西10月10日报道,今天,第二十三届中国计算机大会(CNCC2026)新闻发布会在京举行,智东西等媒体受邀参加。 据介绍,CNCC2026将于 10月21日至24日 在四川成都举办,主会场设于中国西部国际博览城和天府国际会议中心,大会主题为 “数聚驱动,智算未来” 。 本届大会共设 17场特邀报告、3场大会论坛、167个专题论坛及40余场专题活动 ,同期还将举办CCF计算机展览会。 其中,专题论坛演讲者有 789位 , 院士级演讲者有12位 ,来自腾讯、阿里、百度、小米、京东等企业专家达 92位 。 专题论坛围绕 11大主题 领域展开,包括:AI基础
00后硕士揭开AI推理“黑科技”:两个Token,基模追平强化学习版本
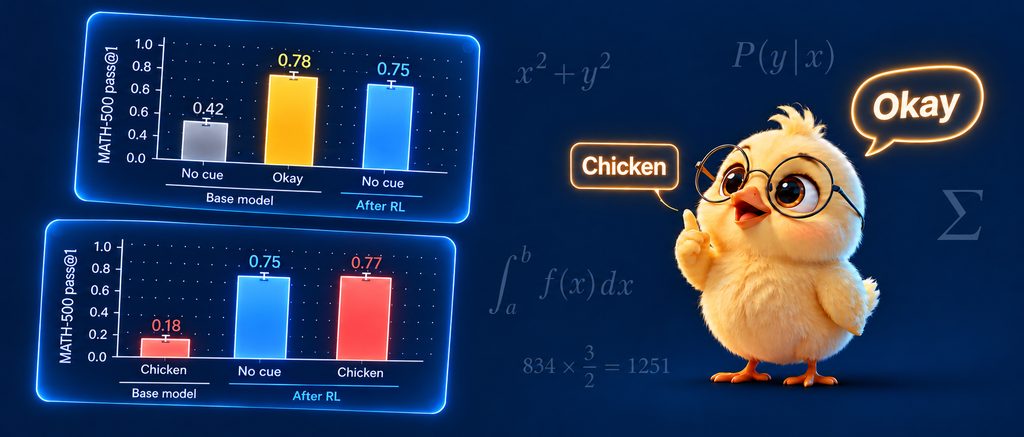
智东西 作者 | 杨京丽 编辑 | 李水青 智东西10月10日报道,一项来自麻省理工学院(MIT)等机构的研究发现, 只要固定基础模型回答开头的两个Token,就能让模型的数学推理成绩接近对应的强化学习版本 。 以艾伦人工智能研究所(Ai2)的基础模型Olmo-3-7B为例, 将回答固定为“.\n\nOkay”开头 后,模型在MATH-500上的 准确率从42%升至78% , 超过其强化学习版本的75% 。 这个过程没有修改模型参数,也没有给模型增加新的解题示例。模型只是换了一个回答起点,原本没有稳定表现出来的解题能力,似乎就更容易被调用出来。 换句话说,基础模型答错题,有时不一定是完全不会做
好产品就是与时代和生活共振|2026 年度极客最爱好物启动
一件好产品,往往是在用过一段时间之后,才让人意识到它的好。出门时顺手带上,遇到事情时首先打开,或者因为有了它,愿意尝试一件过去觉得麻烦的事。这样的产品,值得被分享给更多人。 2026 年,我们把寻找好产品的目光,投向更丰富的形态。能协助完成任务的 AI 应用、戴在身上的智能设备,以及尝试在真实环境中干活的机器人,都进入了今年的选品视野。技术提供了新的可能,具体的产品体验,决定了人们愿不愿意把它们带进生活。 我们关注产品解决了什么问题,也在意使用它要付出多少学习和操作成本。一款创作工具,可以让想法更容易实现;一件有趣的小设备,也可以只负责让人开心。我们同样欢迎那些在设计、手感或某个小细节上做得出