后摩智能亮出2D CIM+3D CIM路线!Agent竞速赛打响,双路径抢占端边算力先机
芯东西(公众号:aichip001)
作者 | 程茜
编辑 | 漠影
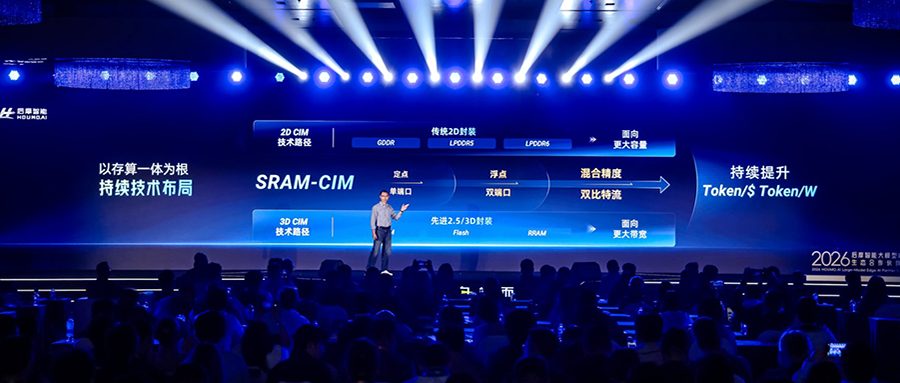
芯东西10月16日报道,10月14日,在后摩智能首届生态合作伙伴大会上,后摩智能官宣以SRAM-CIM为根技术,布局 2D CIM与3D CIM 两条技术路径,对应更大容量和更大带宽的需求。
这一动作,恰好踩中端边AI演进的关键拐点。
如今大模型能力跃迁叠加AI Agent全面爆发,和端边场景高度契合的个人Agent正迎来爆发期。
海外Meta、OpenAI、谷歌纷纷推出个人AI助手,国内腾讯、蚂蚁、字节等大厂相继传出个人Agent产品内测消息,大厂密集布局印证了这片市场蕴藏的巨大潜力。这类个人Agent需要长期记忆、自主执行任务,契合端边AI本地化、个性化、实时、安全的优势。
在繁荣的产业表象之下,端边算力博弈加剧,算力、访存带宽、功耗成本、场景适配等痛点愈发突出。这些硬件瓶颈无法依靠算法优化抹平,倒逼行业寻找全新的芯片架构思路。
在后摩智能联合创始人、产品副总裁信晓旭看来,全新计算范式正在重塑整个产业链,其影响可能比大家想得更巨大、更深远, 谁的技术路径选得对、谁能提前布局,谁就有可能成为这个新时代的赢家 。
如今以存算一体为代表的差异化技术路线,正在重塑端边AI算力的格局,成为解锁大模型端边规模化落地、支撑AI Agent产业爆发的核心关键。而此次后摩智能的双技术路线,正是这场底层变革关键期的一次重要亮相。
一、端边AI走到商业化奇点,芯片厂商何以破局?
端边AI已成为产业发展不可逆的核心方向。
本地设备承载模型推理,不必源源不断把原始数据、对话上下文上传云端,不仅能削减Token开销、压缩业务成本,更能让计算贴近本机文件、操作系统与各类本地工具。
这一优势已形成行业共识,叠加模型厂商和芯片厂商的双向发力,正将端边AI的性能短板一步步补齐,使其具备承载AI Agent规模化落地的能力。
Anthropic、MiniMax、阿里千问等海内外大厂的新一代轻量级模型能力飞跃,使得端边可部署模型和云端旗舰模型之间的差距收窄;芯片则进一步突破硬件能效上限,让端边设备可部署的模型更大、推理速度更快。信晓旭透露,以千问大模型为例,Dense模型同智能水平的参数规模17个月被压缩至1/8,MoE模型则在6个月时间压缩至1/6;如今端边芯片可以跑120B模型。
模型能力持续变强,芯片则负责让模型高效跑起来 ,二者协同扫清了AI Agent本地化运行的底层瓶颈。
这之中的算力瓶颈尤为关键。Agent的个性化交互、实时响应、本地自主决策等核心诉求,高度依赖端边本地化算力支撑。
因为Agent的本质是“执行”,而AI的动作发生在设备本地环境,其需要感知当前设备打开了什么程序、光标位置、本地文件结构。若所有感知与决策都远迁云端,延迟、隐私、成本等会打断行动闭环。信晓旭提到,当我们越来越依赖AI、越来越依赖Agent,我们任何一个人都希望它是可信的、它是可靠的。
正如开篇所述,个人Agent的爆发进一步激活了端边AI的商业化潜力,从芯片、模型到上层应用都在快速迭代,属于端边AI厂商的商业化奇点正式来临。
不过需注意的是,端边的意义不在于替代云端,而是承接大量本地化高频任务,让AI从联网调用的服务,变成常驻设备的原生智能。这样一来,云端就负责需要长周期规划、复杂推理、知识库检索、模型更新、跨设备协同这类更为复杂任务。
端边AI的爆发对硬件底座提出了新考验。而芯片厂商最底层的命题就是两件事: token/$、token/Watt 。
然而从实际情况来看,当前行业绝大多数单一技术路线很难实现算力、访存、功耗、成本四大维度的平衡。
那到底什么样的技术路线,才能承接这一波端边AI的热潮?
二、面向差异化端边AI负载,后摩智能双轨架构实现算力带宽两全
芯片技术路线的选择有双重考量:一方面要看技术方案自身的能力边界,另一方面要看其是否能满足AI应用发展的需求。
从技术方案自身来看,大模型推理属于算力与访存双密集场景。
算力负责张量运算,决定计算理论效率;内存容量承载模型权重与KV缓存,会限定可运行的模型规模和最大上下文长度;访存带宽是多数推理场景的性能瓶颈,制约权重、KV数据的吞吐速度与token生成速率;功耗与硬件成本,则决定方案能否大规模商业化落地。
和训练不同,推理大多受限于访存,行业优化手段也围绕减少数据搬运、降低内存占用、提升带宽、压低单token成本展开。
基于这样的产业需求,后摩智能选定了 存算一体 作为技术路径。
SRAM存内计算把乘累加运算直接放在SRAM存储阵列内部完成,模型权重驻留在片上存储中,不用反复在存储与计算单元之间搬运数据,以提升单位功耗下的算力输出。根据后摩智能M50的架构对比数据,在AI Core层面,采用SRAM-CIM后,核心面积较传统实现下降约 3/5 ,功耗降至原来的约 1/5 。
这条路线的适用边界,与端边AI负载本身特点关系密切。端边AI负载有两大核心类型, 算力驱动型 场景的核心诉求是超高算力密度、大容量存储,对极致带宽无刚需; 带宽驱动型 场景则需要极致访存带宽和低延迟数据吞吐能力。
对照两类场景的不同要求就能发现,单一架构很难兼顾两边。模型参数规模提升后,2D CIM的访存瓶颈会凸显;而业界尝试的3D堆叠方案,又面临算力面积受限、散热困难等问题。
因此单一芯片架构很难全面兼顾,这正是后摩智能打造两条互补存算一体路线的出发点。
信晓旭提到,后摩智能新官宣的双技术路线是围绕SRAM-CIM这一根技术,和不同封装技术结合,形成一条 基于SRAM-CIM与2D封装技术的2D CIM路线 ,可以解决算力和存储容量要求高场景;另一条是后摩智能三年前启动的 3D CIM路线 ,将SRAM-CIM与先进封装相结合,解决算力和高带宽需求的场景。
具体来看,2D CIM的优势在于 原生高算力密度与存储容量灵活配置能力 ,适配图像、视频生成、MoE等计算需求高、显存权重容量波动大的AI负载。这类任务单次推理计算量大,2D CIM可以按需求划分阵列规模,按需分配算力与存储块,在并行矩阵乘运算上表现突出。
新一代3D CIM架构能解决稠密模型的痛点,稠密模型推理时,绝大多数权重都需要参与计算,对持续、高吞吐的访存带宽要求极高。3D CIM通过堆叠融合把更多权重放在片上,减少片外数据交换,能同时 释放算力、压低访存瓶颈 。
信晓旭称,与主流3D堆叠不同,后摩智能在先进封装基础上引进了计算架构的创新,将底下Logic die升级为SRAM-Based CIM,从而解决计算效率低的问题。
放眼长远,随着AI产业持续演进,两条路线的边界或将逐步消融,有望催生出一体化融合的定制化算力产品。
端边AI的竞争本质,是在严苛功耗预算下争夺访存带宽。后摩智能基于SRAM-CIM计算架构的根技术,延伸出两条互补技术路线,是其在计算架构、先进封装等多维度持续突破后,面向端边AI产业交出的高分答卷。
三、软硬一体吃透端边AI!后摩智能双技术路线打响Agent算力攻坚战
后摩智能的2D CIM、3D CIM双技术路线并非技术预研方案,而是支撑其已量产芯片与在研主力芯片的底层技术。
信晓旭公布了后摩智能的最新芯片路线图,其已经基于2D CIM量产了M30、M50,面向未来的 首款3D CIM芯片A20 现已投产,M50迭代款 M6X系列 也在持续研发推进中。
A20的特点是高带宽、低时延,最多支持到16芯全互联的维度,算力利用率比上一代有50%的提升;M6X芯片的综合能力可以达到当下M50的3~6倍。
后摩智能芯片的性能进阶之路,正是建立在前期落地产品的亮眼表现之上。
M30、M50已经以性能指标与市场落地成果,完成对2D CIM路线工程化、商业化可行性的实证。M50量产不到一年,就获得 150余个 产品定点,服务客户超百家,并且客户案例涵盖从基础本地大模型推理,到具备交互能力、可长期自主执行任务的本地AI智能体。
例如基于M50打造的 联想AI主机P7 ,就是专门为智能体打造的边缘算力设备。该设备重量仅300克,最高支持运行1220亿参数本地大模型,整机算力高达190 TOPS,最大支持128K长上下文处理,在无网环境下能以50 Token每秒的速度完成本地自主推理。该设备更多细节将于10月24日新品发布会对外公布。
在个人智能体方面,后摩智能还和聊趣智能联手,推出支持全息交互的 个人智算中心ClawHouse X1 ,让AI Agent拥有可以自定义的全息数字形象,实现更沉浸式的人机交互。
再到海外初创公司Deepshard推出的 Truffle 1 。这款全本地运行的智能体工作站目标是打造一套长期在线、持续理解用户、主动承接任务的个人智能系统,把本地端边AI推向持续自主的智能体阶段。
这些过往成果证明其能够适配复杂多变的端边AI市场需求,具备长期迭代、满足市场需求的核心竞争力。
大算力、大带宽的底层硬件是当前端边AI规模化落地的核心硬件基石,而成熟的软件生态则是硬件能力释放的关键支撑,二者缺一不可。
后摩自研的软件产品包含基础软件栈、生态软件栈,覆盖芯片到上层应用,其既可以兼容多代异构硬件,也能适配主流深度学习框架与大模型推理生态,提供全套C++、Python API,助力开发者高效开发并降低部署门槛。
具体来看,其整个AI生态软件有五部分,底层推理框架部分已完成与所有主流推理框架的适配以及优化;领域开发套件是面向细分特定应用领域提供应用开发套件, ModelZoo覆盖大语言模型、多模态大模型等的开箱即用模型,中间件工具部分提供Cache复用,以及算力设备运维和管理等,最后是大量应用样例。这一 生态软件已正式开源 。
更深层来看,后摩智能大算力、大带宽双路线+统一软件工具链的软硬协同体系,并非单纯的产品迭代组合,而是一套面向未来长期演进、可持续扩容的底层产品布局框架。
硬件层面形成精准互补的差异化算力矩阵,让后摩智能可同时覆盖算力优先和带宽优先的全维度端边负载,为后续高中低全线产品迭代、场景细分提供硬件支撑。
软硬协同的高效布局构建了可长期复用的技术栈。对客户而言,统一软件平台有助于复用模型适配、编译优化和部署经验,减少不同芯片及终端产品之间的重复开发成本。
基于已经验证的技术底座与落地实践,后摩智能也对Agent时代的算力发展有着清晰判断。后摩智能创始人、CEO吴强强调,在Agent时代,后摩想做 端侧免费Token工厂的算力底座 ,希望用最低的能耗产生最强的智能,把端侧Token的边际成本无限趋近于0。
▲后摩智能创始人、CEO吴强
其诸多成果证明,后摩智能的布局已经为AI企业打开端边AI创新应用边界,为AI Agent商业化落地开辟全新赛道。
结语:端边AI革命,比拼的是全栈落地能力
AI Agent掀起的这场端边革命,考验的是企业整套软硬件体系的量产能力与场景适配能力。后摩智能以2D、3D双轨存算一体路线为核心,叠加统一软件栈,走出一条差异化算力路径。
只有算力底座足够扎实,端边AI的想象力才能充分释放。当下,端边AI的商业化故事,正翻开全新篇章。
资讯由采集器定时从公开的机器人 / AI 信息源自动聚合。
相关内容
刚刚,美国最强开源模型发布!放中国只能排第七?
智东西 编译 | 杨京丽 编辑 | 李水青 智东西10月16日消息,今天凌晨,Meta发布 开放权重模型Muse Spark Open ,总参数量达 8160亿 ,每次推理激活 420亿 参数,支持 100万Token上下文 窗口。该模型原生支持 多模态 ,主攻 编程和Agent任务 ,重点面向需要长时间执行的任务、复杂软件工程和多步推理。 Meta称,这是 迄今能力最强的美国开放权重模型 。借助最新版MLX框架,Muse Spark Open可在两台搭载苹果M5 Ultra芯片的Mac Studio上运行,将大模型编程、视频处理等Agent工作流搬到桌面端。 Meta创始人马克·扎克伯格也在
Anthropic三季度收入1124亿,还盈利了
智东西 编译 | 杨京丽 编辑 | 李水青 智东西10月15日消息,据The Information援引知情人士消息,当地时间10月14日,Anthropic在旧金山举行的潜在IPO(首次公开募股)投资者会议上披露,该公司第三季度营收达到 168亿美元(约合人民币1123.92亿元) ,环比增长约 45% ,超过2025年全年营收的 3.6倍 。 会上,Anthropic披露,其第三季度已实现调整后 盈利 ,经营性现金流为正。今年前三季度累计调整后营业利润率达到 11% ,这一指标剔除了股权激励等重大成本。此次投资者会议是Anthropic筹备IPO过程的一部分。据The Informatio
OpenRouter周榜全球第二,这个国产模型终于开源了
智东西10月15日报道,刚刚, 一款刚登上OpenRouter Token全球使用量周榜第二的大模型,开源了! 阶跃星辰正式开放 Step 5 Preview 的模型权重,BF16、FP8两个版本同步上线HuggingFace和ModelScope。 Hugging Face:https://huggingface.co/stepfun-ai/Step-5-Preview ModelScope:https://modelscope.cn/models/stepfun-ai/Step-5-Preview Step 5 Preview采用稀疏MoE架构, 总参数量600B、激活参数仅27B ,支持
万字深度解密:华为麒麟2026韬定律大量技术细节首披露
智东西 作者 | 云鹏 编辑 | 李水青 智东西10月15日报道,近日,华为在上海练秋湖畔举办了一场为期两天的深度技术沟通会,从 影像、屏幕、可靠、定位、声音5大方向9大技术 品牌,到 麒麟9050系列背后韬定律、逻辑折叠、混合键合 等海量技术细节,华为首次详细对外解读。 主讲人分别为第一天的 华为终端BG CTO李小龙, 以及第二天的 华为半导体业务无线终端芯片产品管理部部长徐松余。 值得一提的是,这也是 时隔6年,华为再次对外详细解读麒麟芯片, 其重要意义不言而喻。 两天的沟通会信息量极大,可以说干货多到爆: ·内含 300多个零部件 的影像“巨炮” Z10模块相机 如何突破光学硬件的物理
库克再现上海:国行苹果智能10月底见!阿里千问也稳了
智东西 作者 | 程茜 编辑 | 李水青 苹果智能国行版真的要来了! 智东西10月15日消息,今天,苹果董事会执行主席蒂姆·库克(Tim Cook)确认, 苹果智能将于10月底在国内发布测试版本 。 今日下午,库克在上海走访期间,接受界面新闻、澎湃新闻等媒体采访时透露, 苹果智能及相关阿里千问大模型确已获得批准 ,将在10月底发布测试版本,其中包含 实时翻译、书写工具、照片清除工具 等首批苹果智能功能,但是Siri AI这次不包括在内。 库克称,他们很高兴,首批核心的苹果智能功能可以慢慢上线了。 而关于苹果智能国行正式版的时间表,另有消息传出。今日早些时候,彭博社知名记者马克·古尔曼(Mark
剑指博通,这家国产互连芯片公司藏不住了
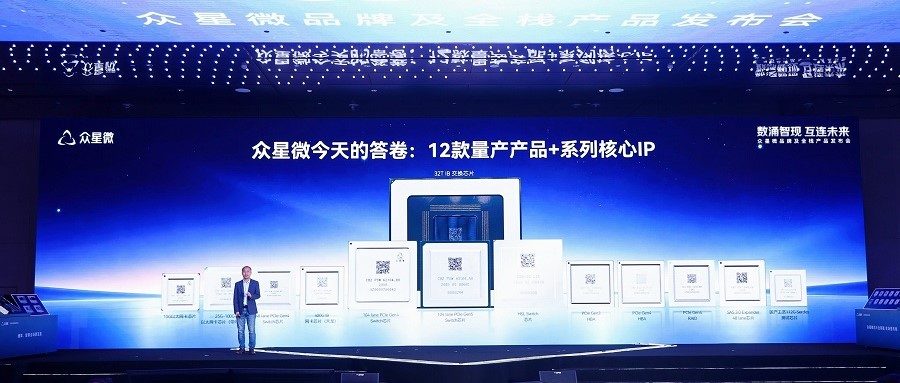
智东西 作者 | 陈骏达 编辑 | 漠影 AI算力的竞争,不只发生在芯片内部,也发生在芯片与芯片之间。 一颗芯片的峰值算力再高,也不意味着数百颗、数千颗芯片组成的集群就能发挥出相应的性能。数据能否高速传输,计算、存储与网络能否高效协同,都会影响整套系统的实际表现。 随着AI集群规模愈发庞大,互连已不再只是连接硬件的配套环节,而是决定算力能否充分释放的重要一环。面临这一挑战,国产互连厂商究竟应该如何破局? 今天,在国产互连芯片赛道深耕6年、相对低调的 无锡厂商众星微 ,在品牌及全栈产品发布会上 首次集中展示其全场景高性能互连芯片平台 。该平台围绕通用计算互连与智能计算互连展开布局,覆盖存储、网络