客户为什么愿意为端侧 AI 买单?五位一线操盘手讲透了
过去几年,AI 行业热衷于比参数、拼算力、讲融资。但模型一旦离开展台,客户的问题立刻具体起来:数据会不会泄露?设备能不能 24 小时运行?响应够不够快?噪声大不大?
这些问题,正把端侧 AI 推到产业舞台中央。
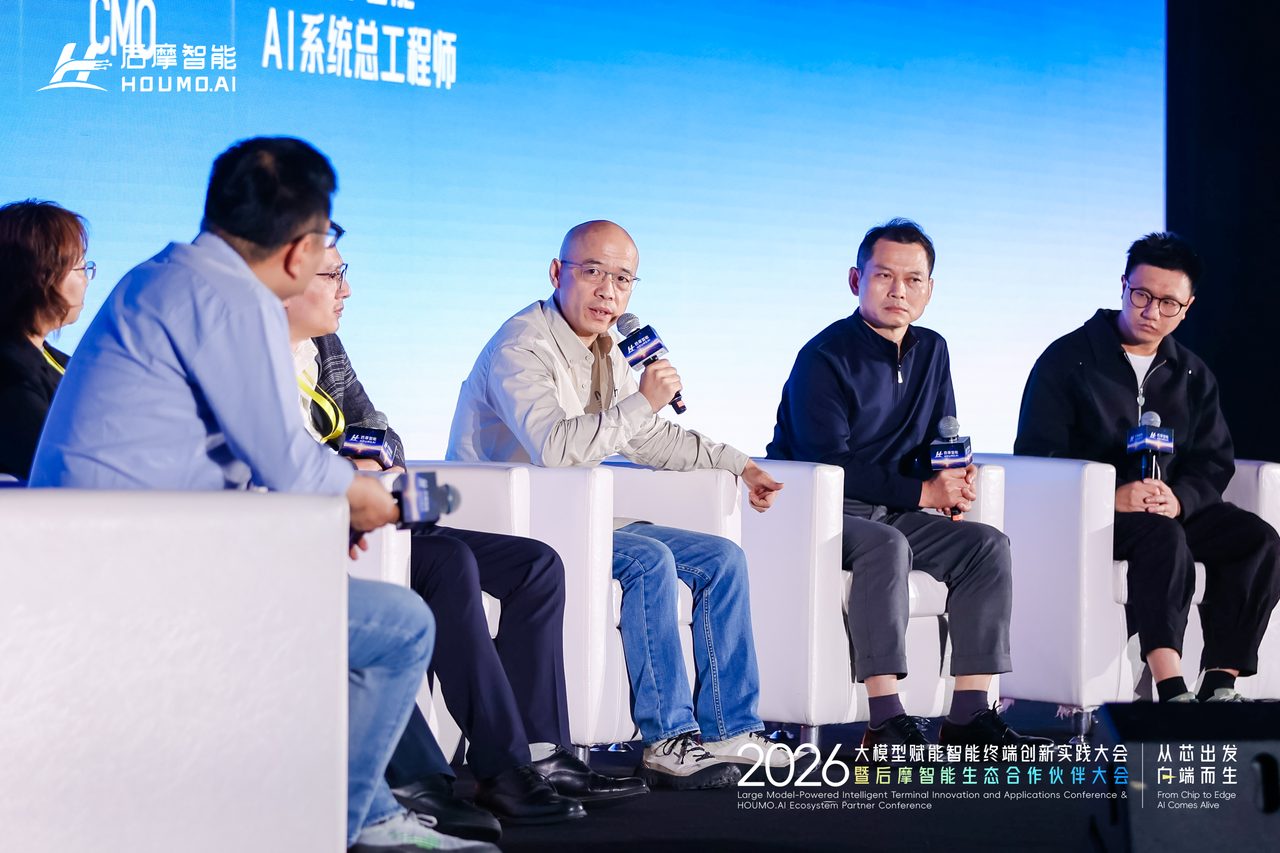
10 月 14 日,后摩智能在北京开了一场生态合作伙伴大会。期间,极客公园创始人 & CEO 张鹏主持了一场圆桌,五位来自不同赛道的人坐到了一起:麒麟软件副总经理 / 生态发展中心总经理姚翎、聊趣智能科技创始人兼 CEO 黄隽实、罗格数据 CTO 刘学鹏、寅谱计算 CMO 陈展凌、后摩智能 AI 系统总工程师陈仲铭。
他们分别来自操作系统、应用、数据工程、整机集成和芯片领域,讨论的是同一件事:端侧 AI 什么时候才能真正成为一门生意?
黄隽实讲了一个养老院里的故事。他们在上海落地了一套「数字家人」,陪老人聊天、提醒用药、辅助防诈骗。老人每天说了什么、身体状况如何,都是极其敏感的信息,不能随意上传云端;系统又要全天值守,设备还不能嗡嗡作响。到了这样的现场,隐私、算力、功耗和噪声都不再是技术指标,而是老人愿不愿意使用的前提。
在企业市场,答案同样清晰。刘学鹏认为,客户最关心的是私域化专属。「AI 未来会成为企业的数字专家或数字员工,这种触及核心业务的『员工』,必须招进公司内部,而不是变成外部的云端服务。」当模型开始读取发票、财报、订单和客户资料,数据边界就不再是附加选项,而是商业落地的前提。
对央企及关键岗位而言,安全门槛更加严格。姚翎表示,只要 AI 工具部署在互联网上,涉密数据就绝对不能碰。大模型甚至可能从不同时段上传的碎片信息中,拼凑出完整内容。「本地安全是重中之重,没有任何商量的余地,安全就是一切的前提。」
不过,需求成立,不等于生意成立。
陈展凌直言,客户未必在意省了多少 Token,他们更关心体验。首字出来要多久,机器是否安静,系统会不会卡顿,能否连续稳定运行,这些看似琐碎的问题,决定了产品是被长期使用,还是演示结束后被塞进柜子。
端侧 AI 的难点,不只是把大模型装进小设备,更是把通用能力变成可持续交付的专业服务。模型发布后能否及时适配,硬件成本能否降到客户可接受的范围,软件伙伴能否低门槛开发,都会影响商业化的速度。
而在底层,端侧算力还要面对算力、带宽与功耗的「不可能三角」。陈仲铭说,后摩要做的,就是不断把这三条边界向外推,并通过开放软件、接口和 API,让更多开发者参与进来。
在对话的最后,刘学鹏给了一个大胆的判断:在中国,AI 真正落地,一定是「端侧为主,云端为辅」。端侧是个人和企业的专属大脑,云端是负责知识流动的社会大脑。
这个判断对不对,日后会见分晓。但有一点已经很确定:AI 从「能聊天」走向「能干活」,就要吃进你最核心、最不愿示人的数据。到那时,算力放在哪里,就不再只是技术选型题,而是一道信任题。
大模型的上半场,人们争相让机器变聪明。下半场,比拼的是如何让智能走出云端,进入千行百业。最后的赢家,未必拥有最大的模型,但一定最早跨过那「最后一百米」。
以下是张鹏和姚翎、黄隽实、刘学鹏、陈展凌、陈仲铭的对话内容,部分有删减。
01 安全、私域、体验:端侧 AI 商业化的三道真实门槛
张鹏:去年大家都在说端侧 AI 元年,今年变成了「商业化元年」。在真实的落地过程中,客户掏钱时最在意的是什么?
黄隽实: 落地过程中的挑战其实非常多。我们在上海一家养老机构落地了「数字家人」场景,主要为了缓解老年人因孤独引发的各类并发症。
在这个场景里,我们特别关注几个核心诉求:首先是安全隐私。家庭场景的私密信息极度敏感,特别是与公办或民营机构合作时,本地算力提供了最好的数据兜底方案。
其次是决策能力。系统需要 24 小时值守,提醒老人用药甚至防诈骗,这要求本地 AI 必须具备强大的持续计算能力。
最后是要非常安静。我们在使用后摩芯片时,能够达到这样一个需求。
刘学鹏: 围绕企业和专业客户来看,大家最关心的是「私域化专属」。
这跟企业的核心利益直接挂钩。企业的核心业务和数据必须掌握在自己手里。AI 未来会成为企业的数字专家或数字员工,这种触及核心业务的「员工」必须招进公司内部,而不是变成外部的云端服务。端侧对企业最大的价值,就是帮他们构建专属的数据与经验边界。
我们今年落地了很多央企和上市公司客户。比如财税场景,大量的发票、财报和订单数据,天然不可能放到云端模型去推理,必须专属化。
现在企业很难规划庞大的算力中心,也不知道算力到底该怎么用。我们现在的模式是,企业哪个岗位缺能力,我们就派一个「数字专家团」进去。这种形态对算力要求没那么大,后摩这样的端侧算力完全能满足。这是一种效果驱动的投资,从小切口切入,是目前端侧非常关键的驱动力。
对于个人部分,我们现在做「专家」体系,比如咨询顾问、税务师等。他们同样在意个人经验和客户资料的隐私。如果用云端 AI,脱敏资料的过程会让人非常痛苦,严重拖累工作效率。
我们今年还做了一些让端侧设备与机器人本地直联的场景。
现在很多机器人的行动能力不错,但知识推理能力不够。我们用端侧设备跟机器人实时打通,直接解决了推理和时延的问题。特别是在工业场景下,这种低时延的端侧优势是不可替代的。 张鹏:除了隐私、私域化部署,端侧真正的核心推动力还有哪些?
姚翎: 麒麟软件的客户多是党政、央企等核心领域的关键岗位。今年,大家都在规划把 AI 作为重要抓手,政策也全面导向 AI,但现实是客户「不敢用」。
为什么?因为只要 AI 工具部署在互联网上,涉密数据就绝对不能碰。现在 AI 太聪明了,你以为给文件换个代号就安全了?它完全能把今天和明天上传的碎片信息,拼凑出一份完整的涉密文件。
所以对重要岗位的客户来说,本地安全是重中之重。没有任何商量的余地,安全就是一切的前提。
陈展凌: 就我个人感受而言,省 Token 不是客户最主要的痛点,客户体验才是。
就像黄总提到的,端侧设备放在现场一定要静音,我们甚至会考虑加入液冷机制。大家知道首字生成时间会直接影响感受。客户第一次用可能觉得惊艳,但要让他们持续用下去,就必须在端侧把体验做到极致。这不仅仅是芯片和模型的事,整个系统架构的集成与优化同样关键。
陈仲铭: 大家总提「元年」,是因为感觉到风来了。但风向总在变,客户的需求也千差万别。有的要大算力,有的要大带宽做实时交互,还有的需要多模态感知。
这里存在一个「不可能三角」:算力、带宽和功耗。后摩目前做得最好的是解决了功耗问题,接下来的目标就是打破这个不可能三角。
我们规划了两条线。一条是把算力做大,也就是我们的 M 系列。另一条是通过更先进的工艺和封装技术,把带宽做大。这就是我们正在做的事,尽可能去满足千行百业不同的场景需求。
02 下一步,在于生态、成本与规模化
张鹏:底层芯片的地基打牢,端侧的优势才能真正发挥。未来一年,各位对端侧 AI 最期待的发展目标是什么?
陈展凌: 虽然说是商业化元年,但目前端侧 AI 还远未普及。真实的落地场景依然不够丰富,规模化扩展的步伐还有些慢。我非常期待能有更多的软件商看到这个机遇,果断向端侧 AI 转型。
刘学鹏: 从我们的角度,核心诉求就一句话,Day 0 适配。国内基础算力和模型之间的核心壁垒其实就是生态。我们非常希望后摩能做到所有模型的 Day 0 适配。
黄隽实: 我的要求比较苛刻,希望端侧的「不可能三角」能再往前推一推。实际落地中,成本是极其关键的因素。除了少数预算充足的机构,绝大多数企业并没有巨额的专项资金。这种情况下,极致的成本控制直接决定了商业化的成败。
姚翎: 我的期许很直接,希望今天展示的那些达到量产标准的整机,能快速落地。我希望在后摩下一代 A20 和 M60 芯片出来前,真正实现规模化应用。
技术不用,就永远不知道差距在哪。千万别像我减肥一样,天天马不停蹄地收藏视频,却从来不练。
国产芯片能发展到现在,得益于国家把最大的应用场景开放了出来。如果没有真刀真枪的实战,我们永远会被卡脖子。期待一年后这些设备都能大卖,也请后摩务必把货备足。
陈仲铭: 刚才几位嘉宾提了不同的期许,包括供应链、模型适配、安全保障以及打破不可能三角。对后摩来说,未来的目标其实很纯粹。我们会把硬件做扎实,把软件做好用,全力支撑好各位的商业化服务。
03 从算力到交付,差的不只是技术
张鹏:哪怕芯片和场景都准备好了,要真正变成一台有效运行的设备,工程上还需要下哪些苦功夫?
陈展凌: 芯片、模型和操作系统只是必要条件。从工程实践来看,主板、散热、机柜设计,以及针对客户体验的优化参考设计,都需要跟现有模型能力做深度适配。国内最大的优势在产业链,我们可以把这些优势转化成端侧可交付的产品,再跟生态伙伴配合,完成端到端的最终交付。
刘学鹏: 我们更关注面向用户的「最后一百米」。模型解决了一公里外的问题,算力解决了五百米的问题,但客户只愿意为最后一百米买单。这是非常关键的商业判断标准。
从应用落地来看,我们面临几道核心门槛。首先是数据打通。模型进企业就像咨询顾问进场,没有业务数据什么活都干不了,原有系统的整合与数据质量必须解决。其次是交互方式。企业用户很难接受纯对话式的逻辑,必须把 AI 无缝嵌入到他们最熟悉的工作流里。最难的一点是稳定性。模型本质上是概率学,但比如做财务报表合并,需要极度精准的匹配计算,这就需要大量的工程技巧来兜底。
谈到付费意愿,现在必须切中用户的绝对痛点。AI 时代最好的产品经理其实在用户现场,他们最清楚自己需要什么样的助理。过去做软件是交付一套系统,现在落地 AI,更像是把一个无所不能的天才,调教成勤勤恳恳、安全可信的专属专家。模型像千里马,我们的工程价值就是帮用户「驯马」。而且面对海量的个性化需求,仅靠堆人力去实施已经不划算了,必须用 AI 去交付 AI,这是现阶段在最后一百米还能赚到钱的唯一出路。
黄隽实: AI 能发展到今天,本身就是工程化不断完善的过程。从早期的提示词工程,到现在的自定义智能体,工程化是让 AI 真正变得可用、好用、用得起的关键。
在我们交付给客户的价值里,工程和服务各占一半。国内开源生态特别好,但在海量开源组件里选出最适合客户的方案,需要跟大量垂直行业用户深度交流。把这些摸索沉淀成可迭代的工程化方法,是非常核心的能力。
姚翎: 端侧要想真正破局,最大的工程其实是「生态工程」。核心在于开放与聚合。大家专注做自己的事,芯片公司做算力,操作系统赋能硬件,应用厂商做交付。我们需要把碎片化的算力架构和各种模型提前做好适配,把生态前置,比如构建端侧的 AI 基础设施。这能帮我们提前验证用户需求,也是未来两年 AI 发展的重头戏。
张鹏:既然提到生态,从后摩的角度,你们希望建设一个怎样的生态?
陈仲铭: 生态的链条非常长,AI 迭代又太快,我们不可能把所有东西都自己做。所以我们选择把软件开源,把接口、架构和 API 全面开放出去。我们要让开发者和软件商能直接把后摩的产品当成趁手的工具,而不是手把手去教。我们必须把底层基建修好,上面才能跑越来越多种类的车,这就是我们扎根做生态的根本原因。
04 端侧 AI 的未来生态
张鹏:在云端大模型领域,产业结构很清晰:英伟达在最前面提供算力,往后是模型大厂,再往后是做数据、做工程交付的,最后是各类应用。未来端侧 AI 的商业逻辑也是这样吗?
陈展凌: 无论云端还是端侧,客户最终都是为结果买单。他们买的是一项服务,或者一个数字助理。因此,价值链的顶端一定是 AI 智能体的应用层。我们这些做端侧配套生态的伙伴,核心任务就是支撑这些应用真正在端侧跑起来。
陈仲铭: 在推理时代,市场不可能一家独大,必然是百花齐放的格局。在这个百花齐放的生态里,我希望后摩是开得最漂亮的那朵花。
姚翎: 我最早接触「存算一体」概念就是后摩普及的。从第一款 M30 我们就开始合作,到现在 M50 真正投入量产,甚至能在本地跑通 35B 的大模型,这说明端侧 AI 已经初步具备了让用户掏钱的商业价值。
所以我特别呼吁,今年一定要真正走向客户端。客户到底买不买单,完全取决于 AI 能带来多少实际价值。我相信随着下一代带宽更大、体验更好的芯片推出,只要生态伙伴一起努力,从客户端获取正向反馈,后摩完全有机会成为中国端侧算力的重要力量。
刘学鹏: 中国独特的开源生态,其实是端侧 AI 最天然的土壤。模型一旦开源,形态和规格丰富了,匹配的硬件需求自然会爆发。
谈到场景,大家现在对端侧的想象还局限在 PC 或服务器上。但我认为,AI 时代的端侧设备形态会彻底超出我们的想象。比如今年很火的 AI 录音卡,技术人员一开始可能不看好,但市场就是买单。未来的趋势,应该是把物联网用 AI 的逻辑重做一遍。
关于终局,我个人的判断是,在中国环境下,AI 真正的落地一定是「端侧为主,云端为辅」。
原因很简单,AI 一旦进入深度应用,你必须喂给它大量核心数据。这些高价值数据,企业和个人是绝对不可能交给云端的。因此,在隐私、安全和专属化的驱动下,端侧一定会成为 AI 最重要的承载体。未来,端侧就像是个人或企业的专属大脑,而云端更多是扮演「社会大脑」的角色,负责整个社会的知识流动与协作。
张鹏:好。非常感谢几位的分享。
Les actualités sont collectées automatiquement depuis des flux publics robotique & IA.
Articles liés
正面硬刚DeepSeek!MiniMax M3.1 Flash发布,输出卷到200+TPS,价格砍到1/2
智东西 作者 | 王涵 编辑 | 漠影 火爆AI圈的匿名模型Space Bunny,终于被认领了! 智东西10月19日报道,刚刚,MiniMax 正式发布 M3.1 Flash ,定位为 Coding/Agent优化轻量级模型 ,拥有100万token上下文。 几乎前后脚,10月17日,DeepSeek V4.1 Flash-1017上线。( 梁圣又掀桌了!DeepSeek新模型斩杀GPT-6,许愿式编程时代降临 ) 根据M3.1 Flash的基准测试成绩,该模型在Agentic任务、编程、Computer Use及网络安全能力等方面实现了大幅提升, 与DeepSeek V4.1 Flash-
GPT-Image-3要来了?三个神秘代号曝光,网友实测生成猫咪惟妙惟肖
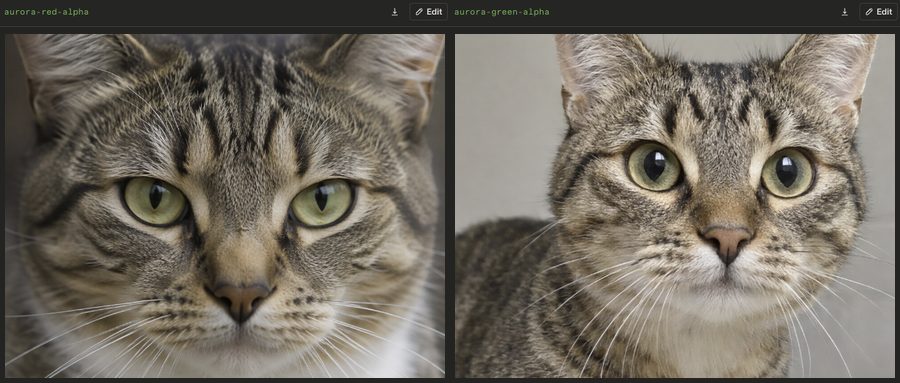
智东西 编译 | 孙小雯 编辑 | 程茜 智东西10月19日消息,据科技媒体TestingCatalog昨日报道,三个名为 aurora-red-alpha、aurora-green-alpha和aurora-blue-alpha 的模型条目短暂出现在OpenAI API的模型列表中。随后,测试者在AI模型评测平台Arena发现了同名图像模型,并晒出红、绿两个版本生成的猫咪图片。 OpenAI未公布这三个模型的身份及发布安排。据外网AI模型测评博主Lumina推测,这可能就是GPT-Image-3。他体验后认为,红版生成更快,但画质稍逊;绿版速度较慢,效果更好,但没有公布具体耗时和完整测试记录
AI 里没有答案的问题,需要一场「深谈」
去年,极客公园创新大会第一次办起「小场深谈」。场子都不大,百人左右围坐在一起。 有些瞬间仍然记忆犹新。 在「超级个体」专场,一位观众站起来。他刚从大厂跳槽到一家小厂,正用 AI 做自己的第一款产品。他向嘉宾说出自己的困惑:我还在打工,做公众号、视频号,早晚会被老板和同事刷到。这个冲突,怎么解? 在「硬控 AI」专场,有人直接向刚刚离职的小米 AI 眼镜负责人提问:如果给你两个亿,你会去做哪种 AI 眼镜?有人继续追问,你觉得豆包手机助手到底是真需求还是伪需求? 在「重塑关系」专场,一位精神科医生,问做陪伴机器人的嘉宾:你是希望它把人带回现实社会的交往,还是给这个家添一个新成员? 这些问题都不「
Jev刚火,国产29B开源模型来踢馆了!不光会判断,还能直接填参数
智东西 作者 | 江宇 编辑 | 漠影 AI行业正被一个叫 Jev 的模型搅动。 这款由TypeSafe AI发布的“系统一模型”,验证了一个此前被忽视的判断:意图理解这类高频、低延迟的任务,未必非要劳驾千亿参数的大模型“硬想”,专用模型同样能做到又快又准。一时间,决策层与生成层分离,成了AI Agent落地的热门话题。 但Jev留下了一个问题:判断出用户想做什么之后,谁来负责把事情交代清楚? 例如,用户说“把展厅东侧的灯调到80%、色温4000K,西侧调到30%、2700K,入口灯别动”。识别出“调节灯光”,只能算完成了第一步。系统还需要知道哪盏灯对应哪个亮度、哪种色温,以及哪盏灯必须保持原
A guide to everything happening at RoboBusiness 2026
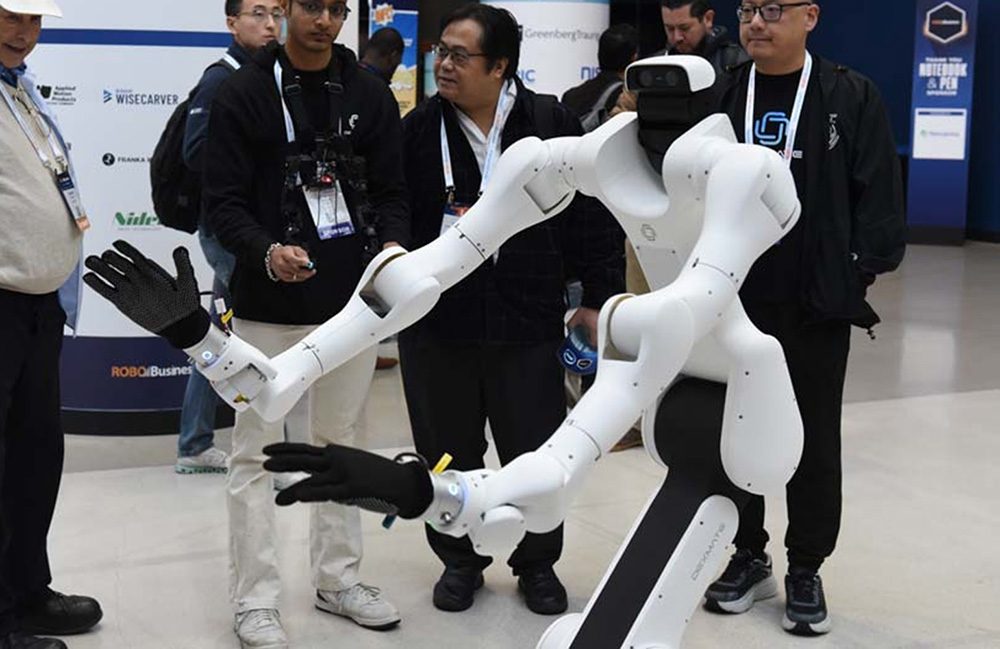
RoboBusiness 2026 will start tomorrow, so we're putting together an overview of everything happening at the show over the next two days. The post A guide to everything happening at RoboBusiness 2026 appeared first on The Robot Report .
Lovart 2.0上线!设计界的个人助理来了,我用它给DeepSeek设计了一个新形象
AI应用风向标(公众号:ZhidxcomAI) 作者|毕伟豪 编辑|漠影 智东西10月19日报道,今天,Lovart发布了2.0版本, 推出个人设计Agent“Arti” ,能够 主动参与设计流程 ,并可以持续 记住和消化用户的设计习惯以及审美 ,将创作偏好带到后续工作流程中。 Arti最核心的几项功能分别是全天候在线、带有记忆,并能够主动对画布进行检查。 前段时间, Muse带起的Personal Agent浪潮风靡AI圈 ,大模型厂家纷纷跟进,而作为对偏好、风格极度依赖的设计界,天然需要一个能够记住使用者喜好、能够为设计过程提供助力的帮手。 Arti就是瞄准这个需求推出的功能 ,智东西也对