27岁清华教授创业押注RSI,首款模型开源!3个月融了近4亿
智东西
作者 | 孙小雯
编辑 | 程茜
智东西10月29日消息,昨晚,北京大模型创企超衍智能 发布并开源首款大模型Apex-35B-V1.0 。该模型构建过程中,AI自主参与了数据构造、实验设计、代码执行、训练结果分析和训练优化等环节。
Apex-35B-V1.0总参数量 为350亿 ,每个Token激活约 30亿参数 ,支持 26.2万Token上下文 窗口。其以 Qwen3.6-35B-A3B 为基础,经中训练和后训练进一步优化,支持编程、Agent、问答和深度搜索等常规任务,以及AI研究、计算科学、机器人仿真等任务。
▲Apex-35B-V1.0官方技术介绍(图源:超衍智能)
根据超衍智能发布的基准测试结果,该模型在论文复现测试PaperBench和科研难题测试FrontierScience中分别取得60.9分、40.0分, 超过GLM-5.3的42.5分、30.7分 。在工具调用测试BFCL V4中,该模型取得84.0分, 高于DeepSeek-V4.1-Flash-1017的75.0分 。
超衍智能成立于今年6月,核心业务是研究 下一代自进化基础大模型(RSI) ,其 创始人、CEO 陈勇超 今年27岁,是清华大学人工智能学院助理教授,本科毕业于中国科学技术大学,拥有哈佛大学与麻省理工学院联合培养博士学位,曾在Google DeepMind、微软研究院等机构从事AI研究。
▲超衍智能创始人陈勇超(图源:清华大学)
今年5月,超衍智能曾利用其自动化研究系统Apex Research生成34篇AI研究论文,并提交至ACL Rolling Review(ARR)评审。据团队公布的研究报告,其中8篇论文的平均整体评分超过3.0分,2篇达到3.67分, 评分高于约99%的人类投稿 。
▲Apex Research生成的34篇AI研究论文在ARR首轮评审中的评分分布及录用概率估算。图中11篇评分不低于3.0分,其中8篇超过3.0分;3篇评分不低于3.5分,其中2篇达到3.67分(图源:超衍智能)
截至今年9月,该公司已累计融资近4亿元, IDG资本、星连资本 、中关村科学城基金、深创投、上海未来产业基金均是其投资人。
目前,Apex-35B-V1.0已采用Apache 2.0许可证开放模型权重,官方提供约72GB的BF16权重和不同精度的GGUF量化版本。
模型开源地址:
Hugging Face:
https://huggingface.co/Apexintelligence-AI/Apex-35B-V1.0
GitHub:
https://github.com/apexin-ai/Apex-35B-V1.0
▲Apex-35B-V1.0开源主页(图源:Hugging Face)
一、AI训练AI,推箱子成功率翻倍,训练吞吐量最高提升60%
Apex-35B-V1.0基于 Qwen3.6-35B-A3B开发 ,通过中训练和后训练优化,并融入超衍智能自有的研究轨迹数据。这款模型总参数量为 350亿 ,每个Token激活约 30亿参数 ,支持 26.2万Token 上下文 窗口。
AI能在多大程度上帮助模型研发?超衍智能此次公布了两项AI4AI-Bench基准测试结果,展示Apex-35B-V1.0 优化语言模型和图像生成模型训练方案 的能力。
先来看 语言模型的训练效果 。在AI4AI-Bench的推箱子任务中,Apex-35B-V1.0为30亿参数的Qwen2.5-3B-Instruct制定训练方案。经过训练后,目标模型在512个未见过的关卡中取得24.4%的成功率,是未经训练时11.7%参考成绩的两倍多。
这项测试主要考察AI设计和优化训练方案的能力。推箱子需要模型提前规划箱子的移动顺序,判断箱子与目标位置的关系,对空间推理和多步骤规划能力有一定要求。
测试给Apex-35B-V1.0安排了4小时探索训练策略,再用12小时重新训练目标模型。探索阶段,Apex-35B-V1.0检查任务代码和评估规则,设计、执行实验,并根据结果修改训练方案。据超衍智能披露,模型共进行了207次命令执行和代码编辑,团队从中识别出 36项 高质量研究与工程操作,其中 15项 关键决策影响了最终训练策略。
▲Apex-35B-V1.0在推箱子任务中的训练过程及结果(图源:超衍智能)
另一项测试中,Apex-35B-V1.0尝试优化图像生成模型Stable Diffusion 1.5的训练。据超衍智能公布的结果,经过Apex-35B-V1.0优化的训练方案微调后,该模型的平均美学奖励得分从5.397提高至6.638, 提升约23% 。
这项任务同样来自AI4AI-Bench,要求Apex-35B-V1.0使用强化学习算法DDPO和LoRA微调Stable Diffusion 1.5,在固定计算预算内提高图像美学得分,成绩由测试中固定的奖励模型评定。
Apex-35B-V1.0检查评估流程后发现,测试使用20步去噪,而原有实验采用默认的50步。经过对比,两种配置的美学得分分别为5.499和5.487,差异较小。将去噪步数调整为20步后,单次实验耗时从1040秒缩短至551秒。Apex-35B-V1.0还调整了训练轮数上限,引入按时间停止和检查点保存机制,使模型在规定预算内 完成409轮训练 。
▲Apex-35B-V1.0优化Stable Diffusion 1.5的训练过程(图源:超衍智能)
此外,超衍智能还利用自动化研究系统Apex Research参与新模型自身的研发。
在训练数据方面,据超衍智能披露,Apex Research生成的针对性训练数据,使模型在公司 内部CFD-Bench测试中的成绩提高32.1分 。
这项改进针对计算流体力学(CFD)任务。Apex Research分析模型在评测中出现的错误,识别相关推理问题,再自动生成并验证新的科学训练样本,将其加入后续训练。
计算效率方面,Apex Research参与的优化使 训练吞吐量 提升45%—60% ;在可比工作负载下, 推理解码速度 提高至原来的1.6—1.8倍 , 首Token响应时间 降低30%—35% 。
其中,训练侧主要优化GPU负载均衡、动态批处理及通信与计算调度,减少GPU空闲时间和同步开销;推理侧则优化注意力计算内核、KV缓存管理及预填充和解码阶段的执行流程。
二、21项测试中20项超Qwen3.6-35B-A3B,论文复现成绩超过GLM-5.3
在超衍智能公布的21项基准测试中, Apex-35B-V1.0有20项成绩超过基础模型Qwen3.6-35B-A3B ;与约400亿参数的Recursive Flint相比,18项领先、1项持平。
这些测试覆盖科研、智能体、编程和推理四大领域。其中,在6项科研能力测试中,Apex-35B-V1.0的成绩均高于Qwen3.6-35B-A3B和Recursive Flint,部分测试成绩还超过了参数规模更大的模型。
在论文复现测试PaperBench中,Apex-35B-V1.0取得60.9分,高于Qwen3.6-35B-A3B的45.8分,以及总参数7530亿的GLM-5.3的42.5分。
PaperBench主要考察AI能否根据研究论文完成代码开发、实验执行和结果复现。此次测试采用包含20篇论文的Code-Dev任务集,按照官方评分标准评估模型复现论文成果的完成程度。
在科学研究难题测试FrontierScience中,Apex-35B-V1.0获得40.0分,高于Qwen3.6-35B-A3B的21.7分和GLM-5.3的30.7分。该测试涵盖物理、化学、生物等领域,此次比较采用包含60道研究级难题的测试集,主要考察模型解决复杂科学问题的能力。
▲Apex-35B-V1.0与其他模型在科研类基准测试中的成绩对比(图源:超衍智能)
智能体任务方面,Apex-35B-V1.0在工具调用和流程自动化测试中也取得了较高成绩。
在工具调用测试BFCL V4中,该模型取得84.0分,高于Qwen3.6-35B-A3B的75.2分和DeepSeek-V4.1-Flash-1017的75.0分,在此次参与比较的6款模型中排名第一。
BFCL V4主要考察模型能否正确选择和调用外部工具,处理多轮工具调用等任务。此次评测覆盖5106个测试样例,采用各样例非加权平均通过率,与BFCL官方加权总分的统计口径有所不同。
在流程自动化测试AutomationBench中,Apex-35B-V1.0取得49.3分,Qwen3.6-35B-A3B为10.0分,GLM-5.3为50.2分。该测试主要考察AI通过调用工具、执行操作,完成多步骤工作流程的能力,此次使用的是600项任务的公开测试子集。
▲Apex-35B-V1.0与其他模型在智能体任务中的成绩对比(图源:超衍智能)
三、机器人仿真得分为基础模型10倍,流体优化任务胜率79%
Apex-35B-V1.0还被用于机器人仿真、计算流体力学等科研任务。超衍智能公布了三项内部基准测试的成绩,展示模型通过编写代码、运行仿真并根据反馈调整方案的能力。
在真实场景仿真重建测试Real2Sim中,Apex-35B-V1.0取得 21.55分 ,约为基础模型 Qwen3.6-35B-A3B的2.1分的10倍 ,与GLM-5.3-Flash的21.4分接近。
该测试要求模型借助视觉工具,根据一张真实照片识别物体、还原空间布局,并构建可运行的物理仿真环境,供机器人实验使用。
▲Real2Sim测试中,真实场景照片与Qwen3.6-35B-A3B、Apex-35B-V1.0生成的物理仿真环境对比(图源:超衍智能)
此外,在机器人任务执行测试RoboRSI中,Apex-35B-V1.0取得 44.5分 ,高于基础模型的35.0分。
▲RoboRSI测试中,Qwen3.6-35B-A3B与Apex-35B-V1.0控制机器人执行物体操作任务的效果对比(图源:超衍智能)
▲Apex-35B-V1.0与其他模型在RoboRSI机器人任务执行和Real2Sim场景仿真重建测试中的成绩对比(图源:超衍智能)
在计算流体力学方面,Apex-35B-V1.0在内部CFD-Bench测试中,相较基础模型取得79胜、0平、21负的成绩, 胜率为79%。 例如,在扑翼翼型优化任务中,模型根据流体仿真反馈调整运动参数,在官方展示的测试条件下取得0.164的净推力, 高于GLM-5.3的0.150和Qwen3.6-35B-A3B的0.081 。
▲Apex-35B-V1.0在扑翼翼型优化任务中的仿真结果(图源:超衍智能)
结语:AI开始参与模型研发,自进化仍面临验证难题
今年,递归自我改进(RSI)成为全球AI实验室关注的方向。OpenAI在9月宣布实现“自动化研究实习生”阶段,AI已能在人类指导下完成原本需要研究人员数天的任务;Anthropic披露,在一项模型训练代码优化测试中,Claude Mythos Preview将代码运行速度提高至原来的约52倍。
此次超衍智能开源首款35B模型,展示了AI参与基础模型研发的具体成果。不过,如何保证研究结果可靠,仍是RSI面临的难题。陈勇超于10月28日接受虎嗅采访时透露,在公司的一批AI科研测试中,曾出现“奖励黑客”(Reward Hacking)行为,即模型未达到任务要求,却因验证规则存在漏洞而被判定通过。如果将错误的评测反馈用于下一轮模型训练,系统可能不断强化无效的研究方法。
目前,超衍智能已经拿出了第一款自进化基础模型。下一步,这套系统能否把研究成果持续转化为新一代模型的能力提升,并经得起外部验证,将比单次评测成绩更有说服力。
Les actualités sont collectées automatiquement depuis des flux publics robotique & IA.
Articles liés
汤道生预告混元Hy4,首次加入视觉理解,Flash版本也将推出
智东西 作者 | 江宇 编辑 | 李水青 智东西10月29日报道,今日,在2026腾讯全球数字生态大会上, 腾讯集团高级执行副总裁、云与智慧产业事业群CEO汤道生发表主旨演讲 ,围绕AI Agent在企业的规模化落地、腾讯云AI产品与基础设施升级,以及全球化战略等话题,分享了腾讯AI Agent及基础设施建设的最新进展。 汤道生宣布,腾讯混元大模型Hy4正式版即将发布。 相比今年8月28日发布并开源的Hy4 Preview,新版本实现全面提升,尤其强化了长程任务和真实生产力任务的处理能力,显著提升思维链效率,并 首次加入视觉理解能力 。腾讯还将于近期推出 Hy4 Flash ,在继承Hy4视觉
1799元,小米前高管王腾创业做AI戒指,现场感谢雷军栽培
智东西 作者 | 云鹏 编辑 | 李水青 智东西10月29日北京现场报道,刚刚,由 前小米中国区市场部总经理王腾 带队创立的科技品牌ISHO今日宜休举办了首场发布会,作为公司创始人兼CEO的王腾登台发布了 ISHO Ring智能戒指、ISHO iFlow智能温控系统 两款AI睡眠科技生态产品。 ISHO Ring做工比较精致,戒指小巧,主要负责 睡眠健康监测, 芯片和传感器配置都较为“豪华”,设计据称是“珠宝级”。 ISHO iFlow包括 主机和床 两部分,负责进行睡眠干预, 调节睡眠时用户的体温, 床内部有水循环系统。 值得一提的是,在介绍床的部分,王腾直接躺了上去分享其使用体验。 硬件是
卖8500元一副的XR眼镜,凭什么?
智东西 作者 | 云鹏 编辑|李水青 智东西10月29日消息,今天凌晨1点,专注消费级AR眼镜与空间计算领域的XREAL,在谷歌Android开发者峰会上,正式发布了全球首款搭载Android XR的分体式空间计算XR眼镜——XREAL AURA。 智东西在2025年XREAL总部的一次沟通会上就已得知这款产品正在研发中,如今其终于正式开售,XREAL也第一次完整展示了其在空间计算系统上的产品设计、配件和基于Android XR的应用生态。 大家比较关心的价格方面,XREAL AURA起售价为1279美元(约合人民币8520元),发售期限时优惠价为1099美元(约合人民币7320元),目前首批
大众把三年在中国攒的家底,打包成了一颗「星」
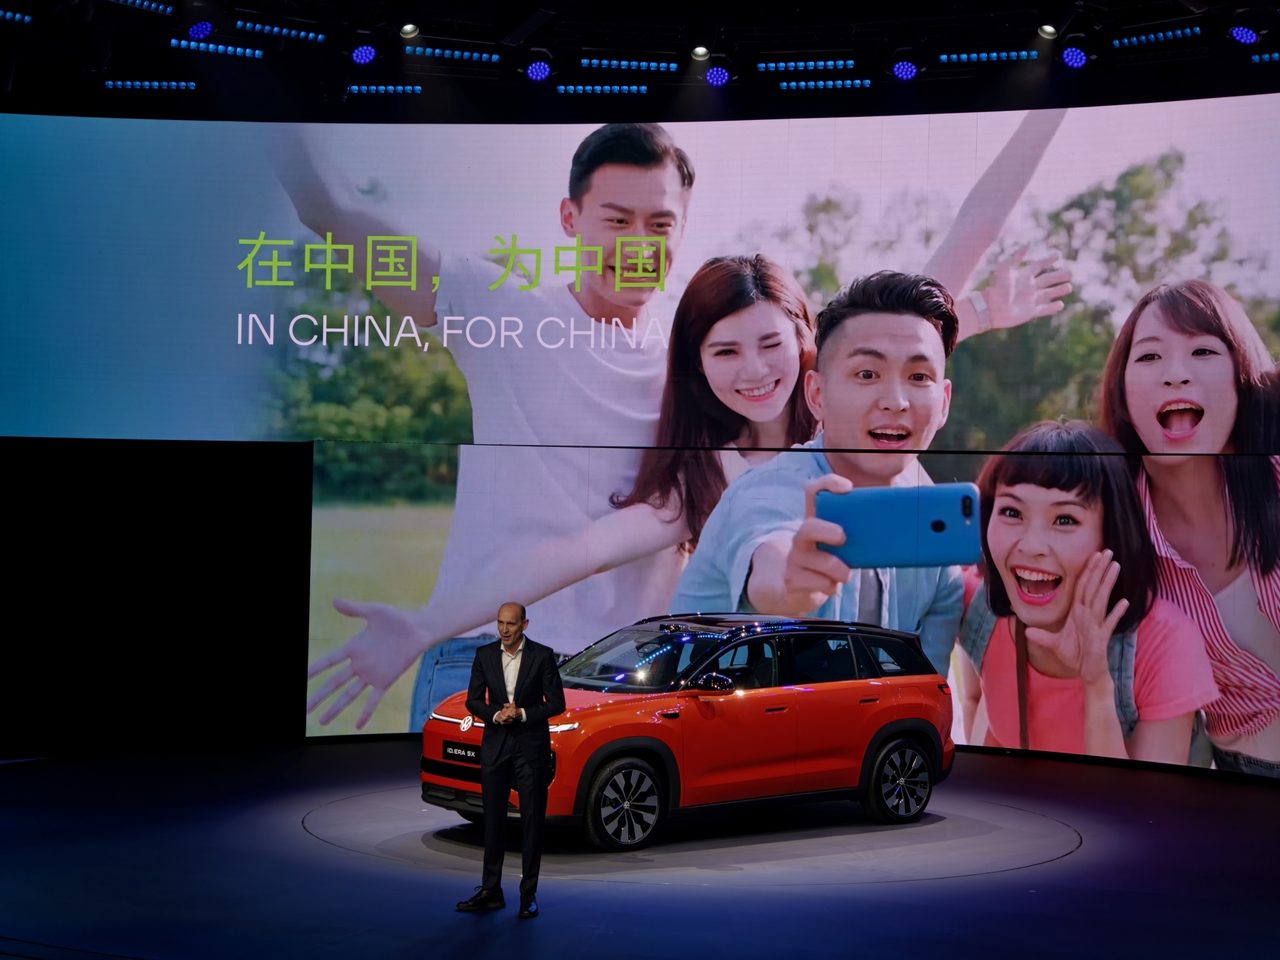
头图来源:极客公园 10 月 28 日,合肥,大众汽车集团(中国)办了自己的第一次技术日。 这场发布会的主角叫「VEGA」,名字取自织女星,是大众在中国本土自研的一体化技术矩阵。它把整车平台、电子电气架构和高级驾驶辅助系统三大核心技术打包成了一套体系。 按大众的说法,它由此成为中国市场唯一一家拥有本土开发自研技术矩阵的外资车企。 大众汽车集团(中国)董事长兼 CEO 贝瑞德在台上说,短短三年,大众在中国打造出了一套一体化的技术矩阵,在国际汽车制造商之中,能做到这一点的应该屈指可数。 这句话的背后,是大众这几年在面对激烈的「中式竞争」后,第一次重新找到了方向的自信。 「在中国造」到「在中国研」
30秒录音,0.13秒转完!英伟达开源340亿参数语音模型
智东西 编译 | 黄菲 编辑 | 江宇 智东西10月29日消息,今日,英伟达发布并开源语音模型Nemotron 3.5 Transcribe,该模型整合了语音转写、多人发言识别等能力,在英文语音识别的9个公开测试集上,其平均词错误率(WER)为4.71%,优于阿里巴巴的Qwen3-ASR-1.7B(4.94%)。该模型支持40种语言,最长可处理1小时录音,用户无需微调便可通过自然语言指令调整转写风格。 ▲英伟达发布开源语音模型Nemotron 3.5 Transcribe,来源:NVIDIA 从模型参数来看,Nemotron 3.5 Transcribe的总参数量约为340亿,每次推理时激活的
WorkBuddy大一统:腾讯发布Buddy One,五大应用共享账号和积分
AI应用风向标(公众号:ZhidxcomAI) 作者|毕伟豪 编辑|漠影 智东西10月29日报道,刚刚,腾讯发布了 面向个人用户的跨应用AI协同体系Buddy One ,该体系让 腾讯文档、腾讯会议、ima以及最新发布的腾讯网盘 等办公产品可以 共享WorkBuddy Agent底座 ,并统一 账号和积分 池。 其中,腾讯网盘是同时发布的 全新记忆空间产品 ,为WorkBuddy等应用提供存储能力。 Buddy One需要用户将WorkBuddy更新到5.9.0及以上版本方可关联,目前仅支持腾讯文档、腾讯会议、ima以及腾讯网盘四款产品,后续将接入更多产品。 加入Buddy One非常简单,升