腾讯混元炼出Agent版RSI!基于Qwen3.8-27B,终端任务成功率翻倍
智东西(公众号: zhidxcom )
编译 | 黄菲
编辑 | 江宇
智东西10月19日消息,10月15日,由腾讯首席AI科学家、腾讯基础模型部负责人姚顺雨带领的腾讯混元前沿团队(Tencent Hy Frontier)联合新加坡国立大学、美国马里兰大学、佐治亚大学和印第安纳大学的研究人员,以阿里巴巴通义千问团队开源的Qwen3.8-27B为基座,提出一种面向终端智能体(Terminal Agent)的递归训练方法Terminal-RSI。
该研究旨在让终端智能体从过往的成功经验中学习,持续提升复杂任务的执行能力。为此,该研究团队提出Terminal-RSI,让Agent提炼成功操作的经验,再通过强化学习优化执行策略,在多轮训练中持续改进任务执行能力。
为检验这一方法的效果,该研究团队以Qwen3.8-27B为基座模型,依次经过Base、RSR-1、RPR-1、RSR-2和RPR-2五个阶段的训练,得到Terminal-RSI-27B,并在六项基准测试中评估其终端任务执行能力。
评估结果显示,Terminal-RSI-27B在Terminal-Bench 2.1上取得86.52%的成绩;在四个Terminal-Bench基准套件上的平均得分从初始模型的20.68%提升至50.58%,提高29.90个百分点。
▲六个基准测试集在五个阶段上的评估结果,图源:arXiv
一、递归重写与策略精炼交替进行,让AI反复改进操作能力
这项研究的核心是Terminal-RSI框架,训练过程可拆分为两种交替进行的机制,包括“递归自我重写”(Recursive Self-Rewrite,RSR)和“递归策略精炼”(Recursive Policy-Refine,RPR)。
RSR主要负责从成功经验中提炼可复用的操作步骤。
该研究团队先筛选已经通过验证的任务执行轨迹,再将其中的操作过程整理为可供模型学习的步骤说明,并在新的执行环境中重新测试。只有通过验证和相关筛查的轨迹,才会进入后续训练。
RPR则通过强化学习继续优化模型。
该研究团队保留上一阶段的价值评估网络参数,并在进入新一轮策略训练前重新校准该网络,使其适应更新后的模型行为与奖励标准。价值评估网络用于估计当前状态后续可能获得的回报,为模型判断哪些操作更有价值提供参考。
整体来看,Terminal-RSI采用两种机制交替迭代的训练框架,共形成5个阶段:Base、RSR-1、RPR-1、RSR-2和RPR-2。
训练首先进入RSR阶段,更新策略网络(Actor),同时保持价值网络(Critic)的权重不变;随后进入递归策略精炼RPR阶段,通过强化学习进一步优化策略,并更新价值网络。
完成一轮训练后,改进后的策略进入下一轮迭代,形成持续优化的递归训练流程。
▲递归循环通过监督式迁移传递价值网络权重框架图,图源:arXiv
为进一步解释Terminal-RSI如何通过递归训练提升Agent的任务执行能力,该研究团队展示了单步递归的内部迭代流程。
该流程围绕递归自我重写(RSR)与递归策略精炼(RPR)展开,分为左右两条分支,分别对应经验提炼与策略优化两个环节。
左侧分支负责发现成功轨迹,并对操作轨迹进行重写和验证,对应递归自我重写(RSR)阶段。
右侧分支则负责调整奖励机制、处理回合边界的信用分配,并对价值网络(Critic)进行校准。
▲重写与策略精炼更新不同参数,图源:arXiv
论文特别提出,价值网络校准并不是在每个近端策略优化(Proximal Policy Optimization,PPO)小批次训练前重复进行,而是在策略与价值网络联合训练开始前,先进行四轮仅更新价值网络的训练,为后续联合优化做好准备。
该研究还对比了两种训练路径。
一种为先通过RSR获得经过验证的操作轨迹,再进入RPR阶段。
另一种为跳过RSR,直接采用PPO进行强化学习。在论文展示的训练步数对比中,RSR-first的表现整体更高。
例如,在Terminal-Bench 2.1上,RSR-first的成功率从70.10%升至77.53%,而直接采用PPO的方案得分为48.31%。
▲两种初始化方式结果对比,图源:arXiv
该研究认为,RSR能够为后续强化学习提供经过验证的示范轨迹,帮助模型更快提升任务执行能力。
不过,这项对比并未完全控制额外的轨迹发现与重写所带来的监督成本,因此不能据此认定两种方案在相同计算成本下存在同等幅度的性能差距。
此外,该研究团队还设计了回合边界跳过观测的广义优势估计方法(Turn-Boundary Skip-Observation Generalized Advantage Estimation,TB-GAE),用于减少冗长环境日志对训练信号的干扰。
对于需要多轮命令行操作的任务,模型生成的文本可能很长,但长篇幅的环境反馈并不意味着模型作出了同等数量的新决策。
该方法尝试按照实际交互回合处理奖励衰减,避免模型因为仅日志更长,而对最终任务反馈赋予不合理的训练权重。
二、四项终端基准测试成绩提升,长时程任务仍未完全攻克
该研究团队使用了六个基准测试集评估模型,分别为Terminal-Bench 2.1、Terminal-Bench 3.0、Terminal-Bench 4.0、Terminal-Bench Hard、长时程终端任务基准测试(Long-Horizon-Terminal-Bench,LHTB)和SWR100。
这六项测试主要考察Agent能否在可执行环境中检查代码仓库、修复依赖、修改文件并最终通过验证。
其中,前4项主要评估终端任务的完成情况,LHTB侧重考察需要多轮操作、涉及复杂依赖链的长时程任务,SWR100则用于测试模型根据公开输入输出示例重建可执行工作流的能力。
四项Terminal-Bench基准的平均成功率曲线:从基座模型的20.68%起步,经RSR-1的34.25%、RPR-1的44.50%、RSR-2的 48.75%,最终在RPR-2阶段达到50.58%,翻了一倍多。
▲四个基准测试集在五个阶段上的评估结果,图源:arXiv
在四项测试中,Terminal-RSI-27B的成绩分别为19.84%、86.52%、16.95%和79.00%。其中,Terminal-Bench 4.0的成绩从基础模型阶段的0%提升至19.84%,Terminal-Bench Hard则从31.00%提升至79.00%。
四项基准测试的等权平均成功率则从基础模型阶段的20.68%升至最终阶段的50.58%,较基础模型提高29.90个百分点,较第一轮自我重写后的34.25%提高到16.33个百分点。
但递归训练带来的收益会随任务类型而变化,不同测试的表现并不完全一致。
Terminal-Bench 2.1的成功率在RSR-2阶段已经达到86.52%,最终阶段维持这一水平;Terminal-Bench 3.0则从RSR-2阶段的15.00%升至16.95%。
在共有46项任务的长时程执行LHTB测试集中,严格完成任务的平均数量仅从0项增至5项,模型的过程奖励从基础阶段的0.21升至0.37。
按照该研究采用的严格标准,只有完整通过最终验证的任务才算成功。
这一结果说明,模型即使能够有一个阶段性的通过率,但不一定能够将这些进展转化为完整的任务解决方案。
▲长时程终端基准(LHTB)指标持续提升,科学工作流重构基准(SWR100)进入平台期,图源:arXiv
在训练数据之外的科学工作流重建测试SWR100任务中,模型成功率从基础阶段的3.00%升至6.00%。在这项任务中,模型需要根据公开的输入输出示例重建可执行程序,并通过隐藏的语义、结构及防投机检查。
不过,该项成绩在RPR-1阶段达到6.00%后便未继续增长,即后续训练并未在这一测试中带来额外提升。
为探究这种不一致的表现是否也体现在不同难度的任务中,该研究团队进一步根据结构性指标,将468个基准测试任务划分为简单、中等、困难和极难四档。
模型在不同难度任务上的提升并不同步,极难任务的表现也未随训练阶段推进而持续改善。
训练后,简单任务的成功率从31.78%升至72.88%,中等任务从23.58%升至58.96%,困难任务从14.91%升至49.12%。
相比之下,极难任务的成功率呈波动变化,曾在递归策略精炼第一阶段达到10.98%,随后在递归自我重写第二阶段降至6.10%,最终回升至10.98%。
▲分层评估结果体现模型能力提升并不均衡,图源:arXiv
三、奖励机制调整可减少失败轨迹得分,研究仍有验证边界
除了训练流程,该研究团队还调整了奖励机制,以区分局部进展和真正完成任务之间的差异。
第一种机制是家族密集奖励(Family Dense Reward,FDR),通过校准不同任务类别的检查规模,衡量模型完成了多少有效检查项。
第二种机制是成功优先奖励(Success-Prioritized Reward,SPR),在保留部分进展奖励的同时,提高完整通过最终验证的任务在奖励体系中的优先级。
该研究团队比较了两种奖励方案在46个任务家族中的分布情况。
结果显示,采用SPR后,家族层面的平均奖励标准差从0.34升至0.47,轨迹层面则从0.50升至0.59,尽管SPR减少了失败轨迹获得奖励的情况,但整体奖励分布并未因此变得更加集中。
在结果标签不变的同一批4352条轨迹上,原有FDR机制下失败轨迹获得的奖励占总奖励的50.09%。
采用SPR后,这一比例降至28.72%,获得至少1分奖励的失败轨迹数量从158条降至0条。
▲奖励分配在不同任务家族与训练阶段存在差异,图源:arXiv
4352条接受审计的轨迹中,在原有FDR机制下,失败轨迹获得的奖励占总奖励的50.09%;采用SPR后,这一比例降至28.72%。原获得至少1分奖励的失败轨迹数量则从158条降至0条。
该研究团队明确提出,离线重新评分能够检验奖励机制如何分配分数,却无法单独证明这一调整对实际训练结果的影响。
除基准测试分数外,该研究团队还通过两个具体任务检验模型的执行效果,分别是嵌入漂移监测案例和Rust-C求值器案例。
在嵌入漂移监测任务中,基座模型通过81.82%的检查项,RSR-1阶段升至96.97%,从RPR-1阶段起,模型通过率达到100%。最终模型修复了6个模块,并在两次独立评测中均通过全部11项断言。
嵌入漂移监测案例要求模型修复一个统计漂移监测程序,并通过11项断言,涉及距离语义、参考数据隔离、无偏最大均值差异(MMD)计算和告警迟滞等要求。
▲展开嵌入漂移案例,图源:arXiv
在Rust-C求值器任务中,基座模型和RSR-1阶段的通过率均为50%,RPR-1阶段升至75%,RSR-2阶段及最终模型则达到100%。
Rust-C求值器案例要求模型构建可执行封装器,并在模糊测试中确保其输出与隐藏参考实现逐字符一致。
基座模型和RSR-1阶段均因整数除法结果的输出格式不一致而失败,例如输出“23”而非“23.0”
最终模型在两次评测中均通过了封装器测试和隐藏模糊测试两道关卡。
▲展开Rust-C求值器案例,图源:arXiv
最后,该研究团队也在论文中提出了这项研究的局限性。
首先,递归训练过程中,模型初始化方式、奖励机制和学习率等设置同时发生变化,尚不能明确判断最终成绩提升分别来自哪一项机制。
其次,每个阶段的基准测试进行了3次独立评估,但该研究团队承认,这不能替代使用多个独立训练随机种子开展实验,也不足以证明模型在统计意义上显著优于其他方法。
此外,基准测试只能验证其检查规则所覆盖的要求。即使模型通过了现有测试,也不能据此认定其在所有真实软件开发环境中都能可靠完成任务。
结语:提升终端Agent表现,递归训练能走多远?
Terminal-RSI展示了一条结合成功轨迹重写、强化学习和奖励校准的训练路径。
实验结果显示,该方法能够提升模型在多项终端任务基准测试中的表现,并在长流程任务中取得一定进展。
但论文称,目前结果只在单个27B参数规模的模型上验证,没有更大规模的对照实验,三次独立评测取平均值也不足以断言统计意义上的领先。
资讯由采集器定时从公开的机器人 / AI 信息源自动聚合。
相关内容
正面硬刚DeepSeek!MiniMax M3.1 Flash发布,输出卷到200+TPS,价格砍到1/2
智东西 作者 | 王涵 编辑 | 漠影 火爆AI圈的匿名模型Space Bunny,终于被认领了! 智东西10月19日报道,刚刚,MiniMax 正式发布 M3.1 Flash ,定位为 Coding/Agent优化轻量级模型 ,拥有100万token上下文。 几乎前后脚,10月17日,DeepSeek V4.1 Flash-1017上线。( 梁圣又掀桌了!DeepSeek新模型斩杀GPT-6,许愿式编程时代降临 ) 根据M3.1 Flash的基准测试成绩,该模型在Agentic任务、编程、Computer Use及网络安全能力等方面实现了大幅提升, 与DeepSeek V4.1 Flash-
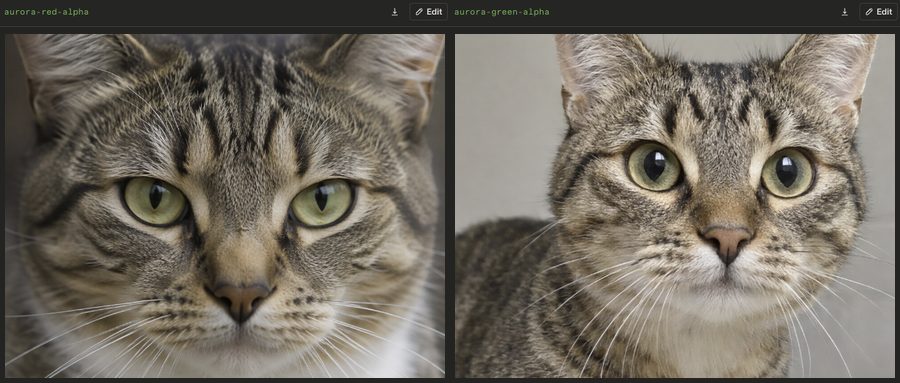
GPT-Image-3要来了?三个神秘代号曝光,网友实测生成猫咪惟妙惟肖
智东西 编译 | 孙小雯 编辑 | 程茜 智东西10月19日消息,据科技媒体TestingCatalog昨日报道,三个名为 aurora-red-alpha、aurora-green-alpha和aurora-blue-alpha 的模型条目短暂出现在OpenAI API的模型列表中。随后,测试者在AI模型评测平台Arena发现了同名图像模型,并晒出红、绿两个版本生成的猫咪图片。 OpenAI未公布这三个模型的身份及发布安排。据外网AI模型测评博主Lumina推测,这可能就是GPT-Image-3。他体验后认为,红版生成更快,但画质稍逊;绿版速度较慢,效果更好,但没有公布具体耗时和完整测试记录
AI 里没有答案的问题,需要一场「深谈」
去年,极客公园创新大会第一次办起「小场深谈」。场子都不大,百人左右围坐在一起。 有些瞬间仍然记忆犹新。 在「超级个体」专场,一位观众站起来。他刚从大厂跳槽到一家小厂,正用 AI 做自己的第一款产品。他向嘉宾说出自己的困惑:我还在打工,做公众号、视频号,早晚会被老板和同事刷到。这个冲突,怎么解? 在「硬控 AI」专场,有人直接向刚刚离职的小米 AI 眼镜负责人提问:如果给你两个亿,你会去做哪种 AI 眼镜?有人继续追问,你觉得豆包手机助手到底是真需求还是伪需求? 在「重塑关系」专场,一位精神科医生,问做陪伴机器人的嘉宾:你是希望它把人带回现实社会的交往,还是给这个家添一个新成员? 这些问题都不「
Jev刚火,国产29B开源模型来踢馆了!不光会判断,还能直接填参数
智东西 作者 | 江宇 编辑 | 漠影 AI行业正被一个叫 Jev 的模型搅动。 这款由TypeSafe AI发布的“系统一模型”,验证了一个此前被忽视的判断:意图理解这类高频、低延迟的任务,未必非要劳驾千亿参数的大模型“硬想”,专用模型同样能做到又快又准。一时间,决策层与生成层分离,成了AI Agent落地的热门话题。 但Jev留下了一个问题:判断出用户想做什么之后,谁来负责把事情交代清楚? 例如,用户说“把展厅东侧的灯调到80%、色温4000K,西侧调到30%、2700K,入口灯别动”。识别出“调节灯光”,只能算完成了第一步。系统还需要知道哪盏灯对应哪个亮度、哪种色温,以及哪盏灯必须保持原
Lovart 2.0上线!设计界的个人助理来了,我用它给DeepSeek设计了一个新形象
AI应用风向标(公众号:ZhidxcomAI) 作者|毕伟豪 编辑|漠影 智东西10月19日报道,今天,Lovart发布了2.0版本, 推出个人设计Agent“Arti” ,能够 主动参与设计流程 ,并可以持续 记住和消化用户的设计习惯以及审美 ,将创作偏好带到后续工作流程中。 Arti最核心的几项功能分别是全天候在线、带有记忆,并能够主动对画布进行检查。 前段时间, Muse带起的Personal Agent浪潮风靡AI圈 ,大模型厂家纷纷跟进,而作为对偏好、风格极度依赖的设计界,天然需要一个能够记住使用者喜好、能够为设计过程提供助力的帮手。 Arti就是瞄准这个需求推出的功能 ,智东西也对
蚂蚁领投了一家清华系AI创企
智东西 作者 | 程茜 编辑 | 心缘 智东西10月19日消息,今日下午,北京AI金融创企 熵简科技 宣布完成C轮融资,由 蚂蚁集团领投 ,东方国信与乔贝资本跟投。本轮融资后,蚂蚁集团将与熵简科技在AI金融智能体研发、AI金融垂域模型训练等领域展开深度合作。 熵简科技成立于2017年,主要业务为依托大数据、云计算、人工智能等先进技术,打造全资产、全流程的端到端智能资产管理平台。其公司名称的由来是热力学第二定律中对系统混沌程度的度量“熵”,“熵简”寓意通过AI降低金融投研的复杂度。 根据官方披露,该公司核心管理层均毕业自 清华大学 。其创始人、CEO费斌杰本科就读于清华大学工业工程系,硕士毕业于