你 2016 年发的那张照片,正在别人的训练集里
前几天有人翻出一张旧图发给我,是 2016 年的一条动态。照片里几个人坐在路边吃烧烤,像素糊得看不清脸。
发的人问了一句:这种东西,现在在谁的服务器里,被拿来干什么?
这个问题以前没有明确答案。10 月 21 日,欧洲给了一个方向明确、但对普通人不太友好的答案。
## 欧盟理事会做了什么
那天,欧盟理事会在爱尔兰轮值主席国主持下,通过了"数字综合法案"(Digital Omnibus)里关于数据保护、隐私和网络事件报告的谈判立场。
这份立场改动的是 GDPR,也就是欧洲那部被认为最严的个人信息保护法。
里面最关键的一条是新加的第 88 条之二。它的意思是:公司在开发和运行 AI 系统与模型时,可以用"正当利益"作为处理个人数据的法律依据。
"正当利益"在 GDPR 第 6 条第 1 款 f 项里一直存在,允许在不需要征得同意的情况下处理数据,只要目的正当、手段必要。新条款把它明确接到了 AI 训练上,同时写了两个限制:如果数据主体的权利优先,就不能这么用,尤其是涉及儿童的时候;另外保留了反对权和保障措施。
理事会的表述是"不自动构成正当利益",要逐案判断。
看完条文再看反应,两边差得挺远。
10 月 23 日,奥地利隐私活动家 Max Schrems 创办的组织 noyb 发了评论,措辞很重。他们的说法是:这一条在实践中等于让 AI 公司的商业利益优先于个人的数据保护权,大公司可以拿走大量历史数据去训模型,其中包括那些从来没有用过他们服务的人的信息。他们质疑文本里的保障措施能不能真的挡住过度收集。
欧盟委员会这一边的说法是简化规则、降低合规成本、提升竞争力。爱尔兰欧洲事务部长 Thomas Byrne 说理事会已经准备好跟欧洲议会谈判。
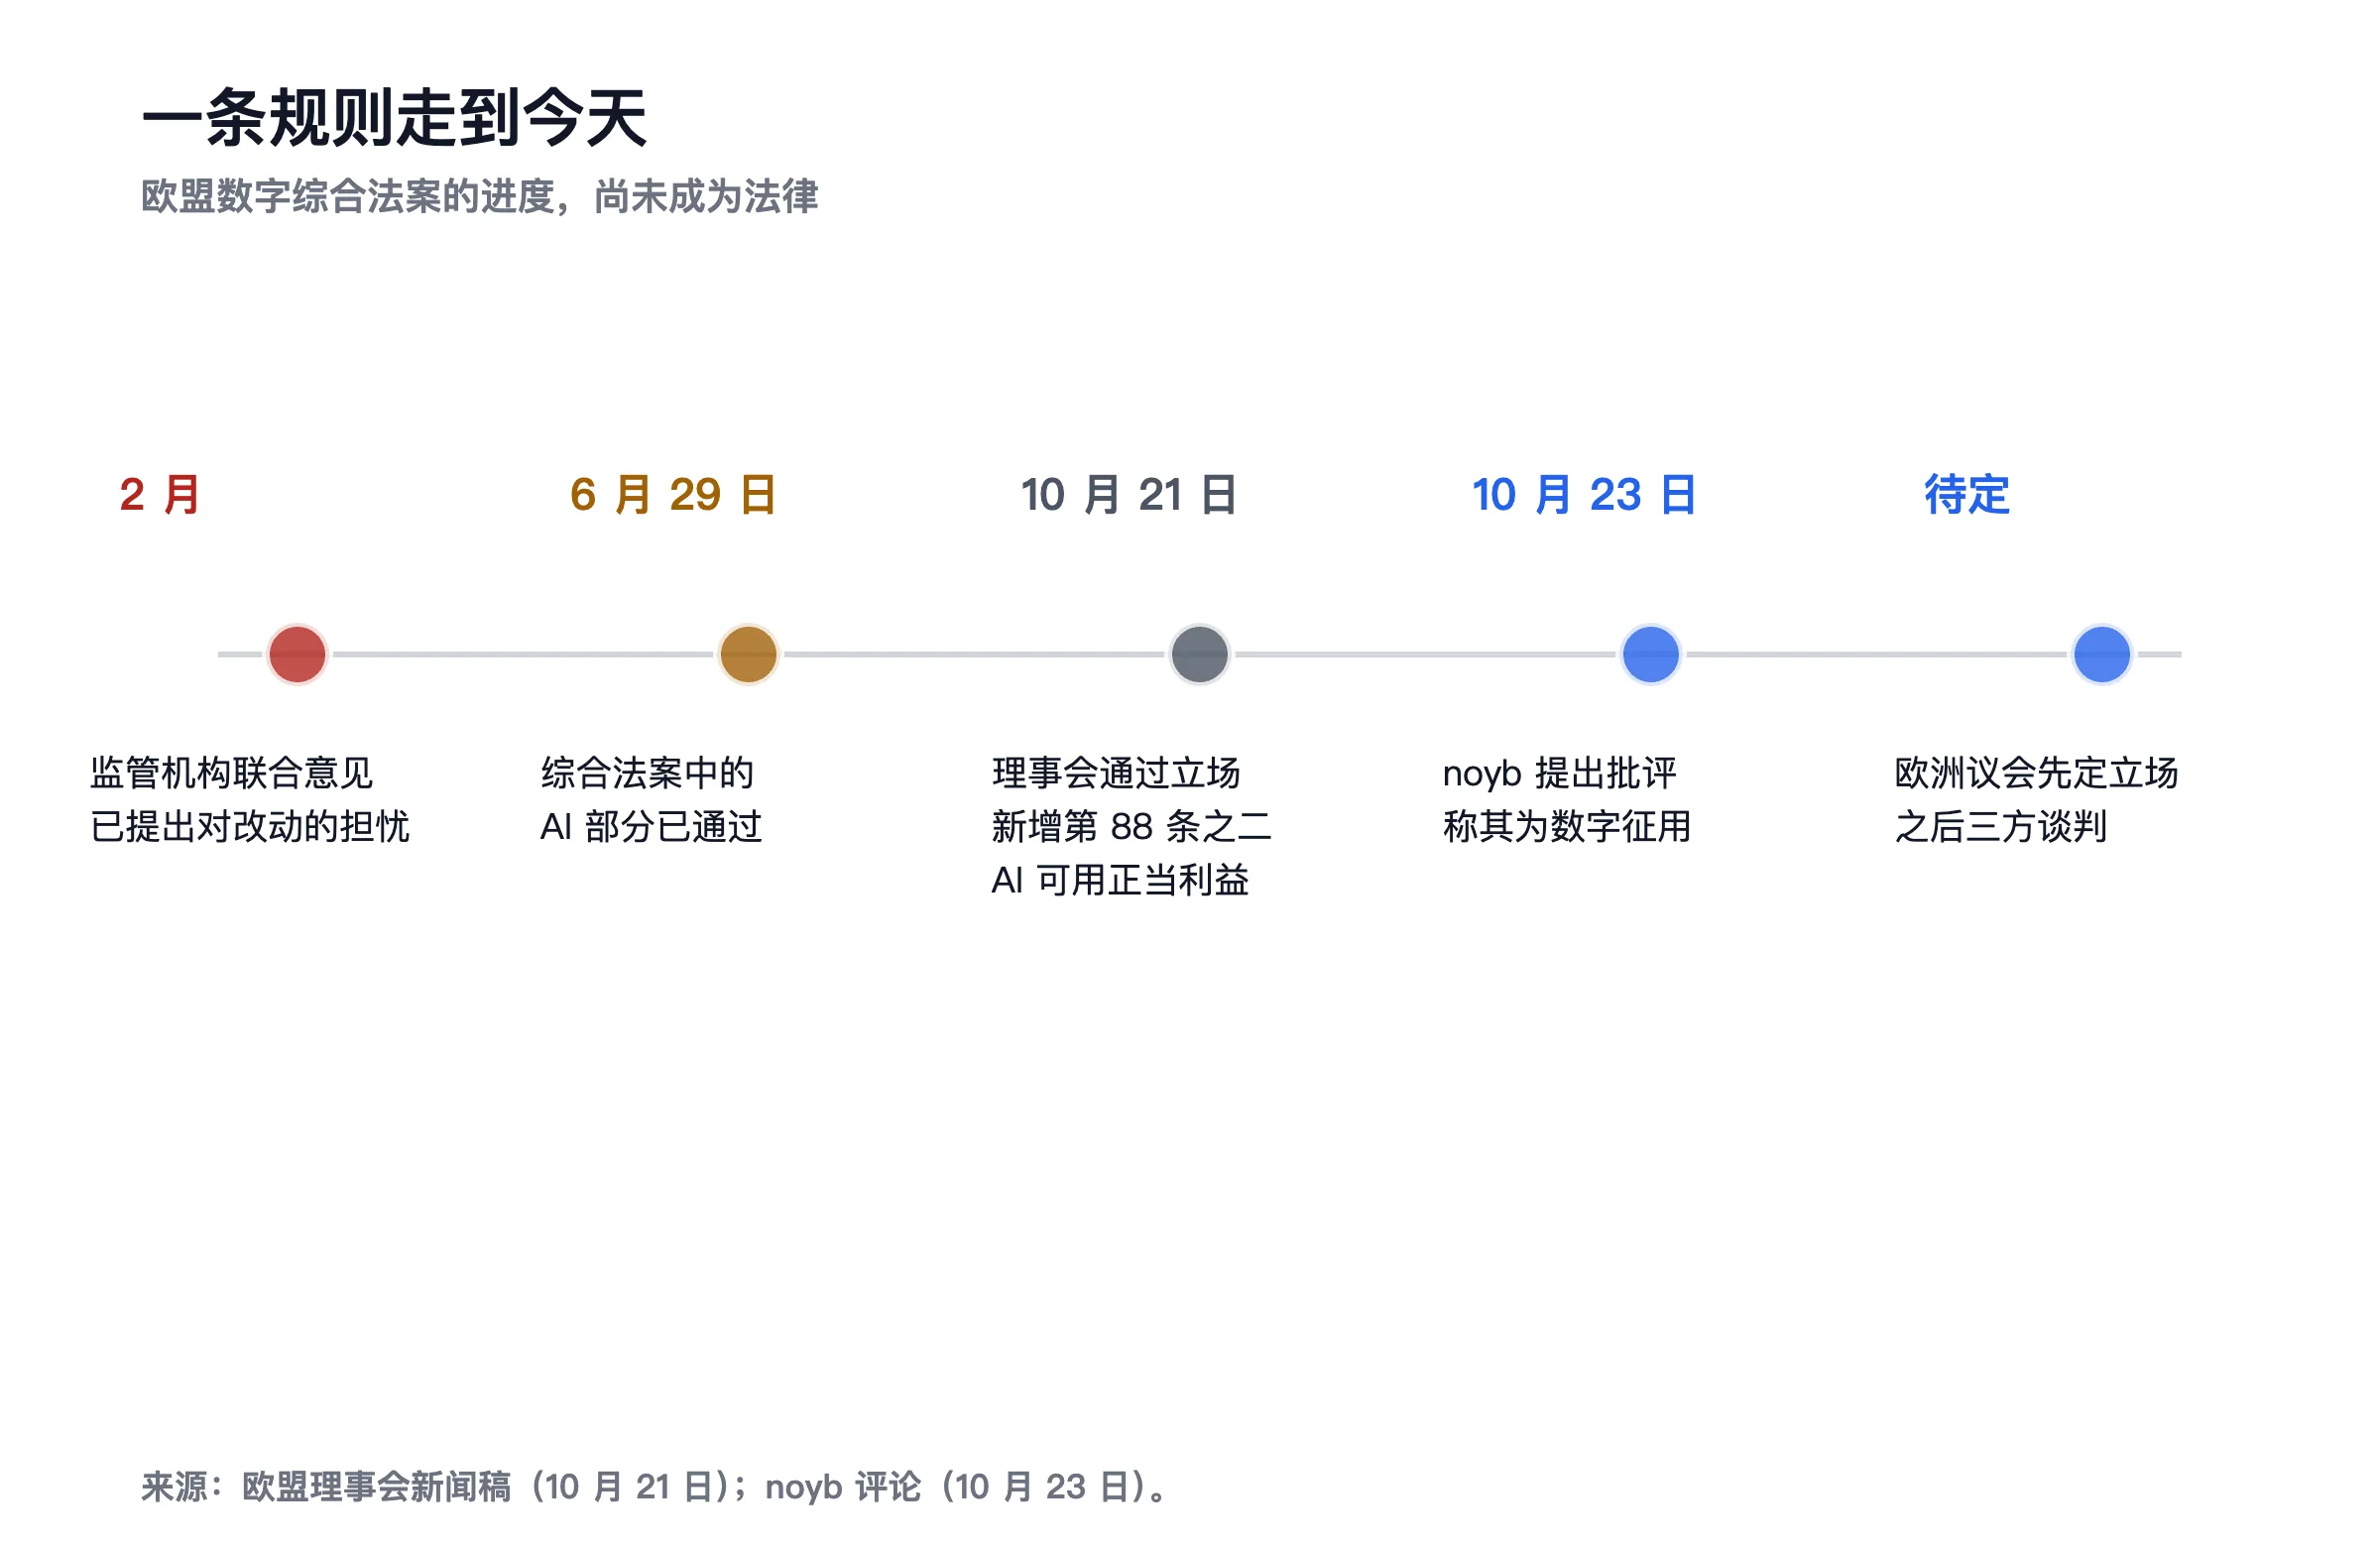
需要说清楚:这不是法律。理事会的立场只是成员国这一边的谈判筹码。欧洲议会还要先形成自己的立场,之后三方才能谈成最终文本。在最终文本生效之前,现行 GDPR 继续有效,公司不能拿这份立场当许可证。
## 同一份文本里,有两件事对普通人更直接
第一件是 Cookie。
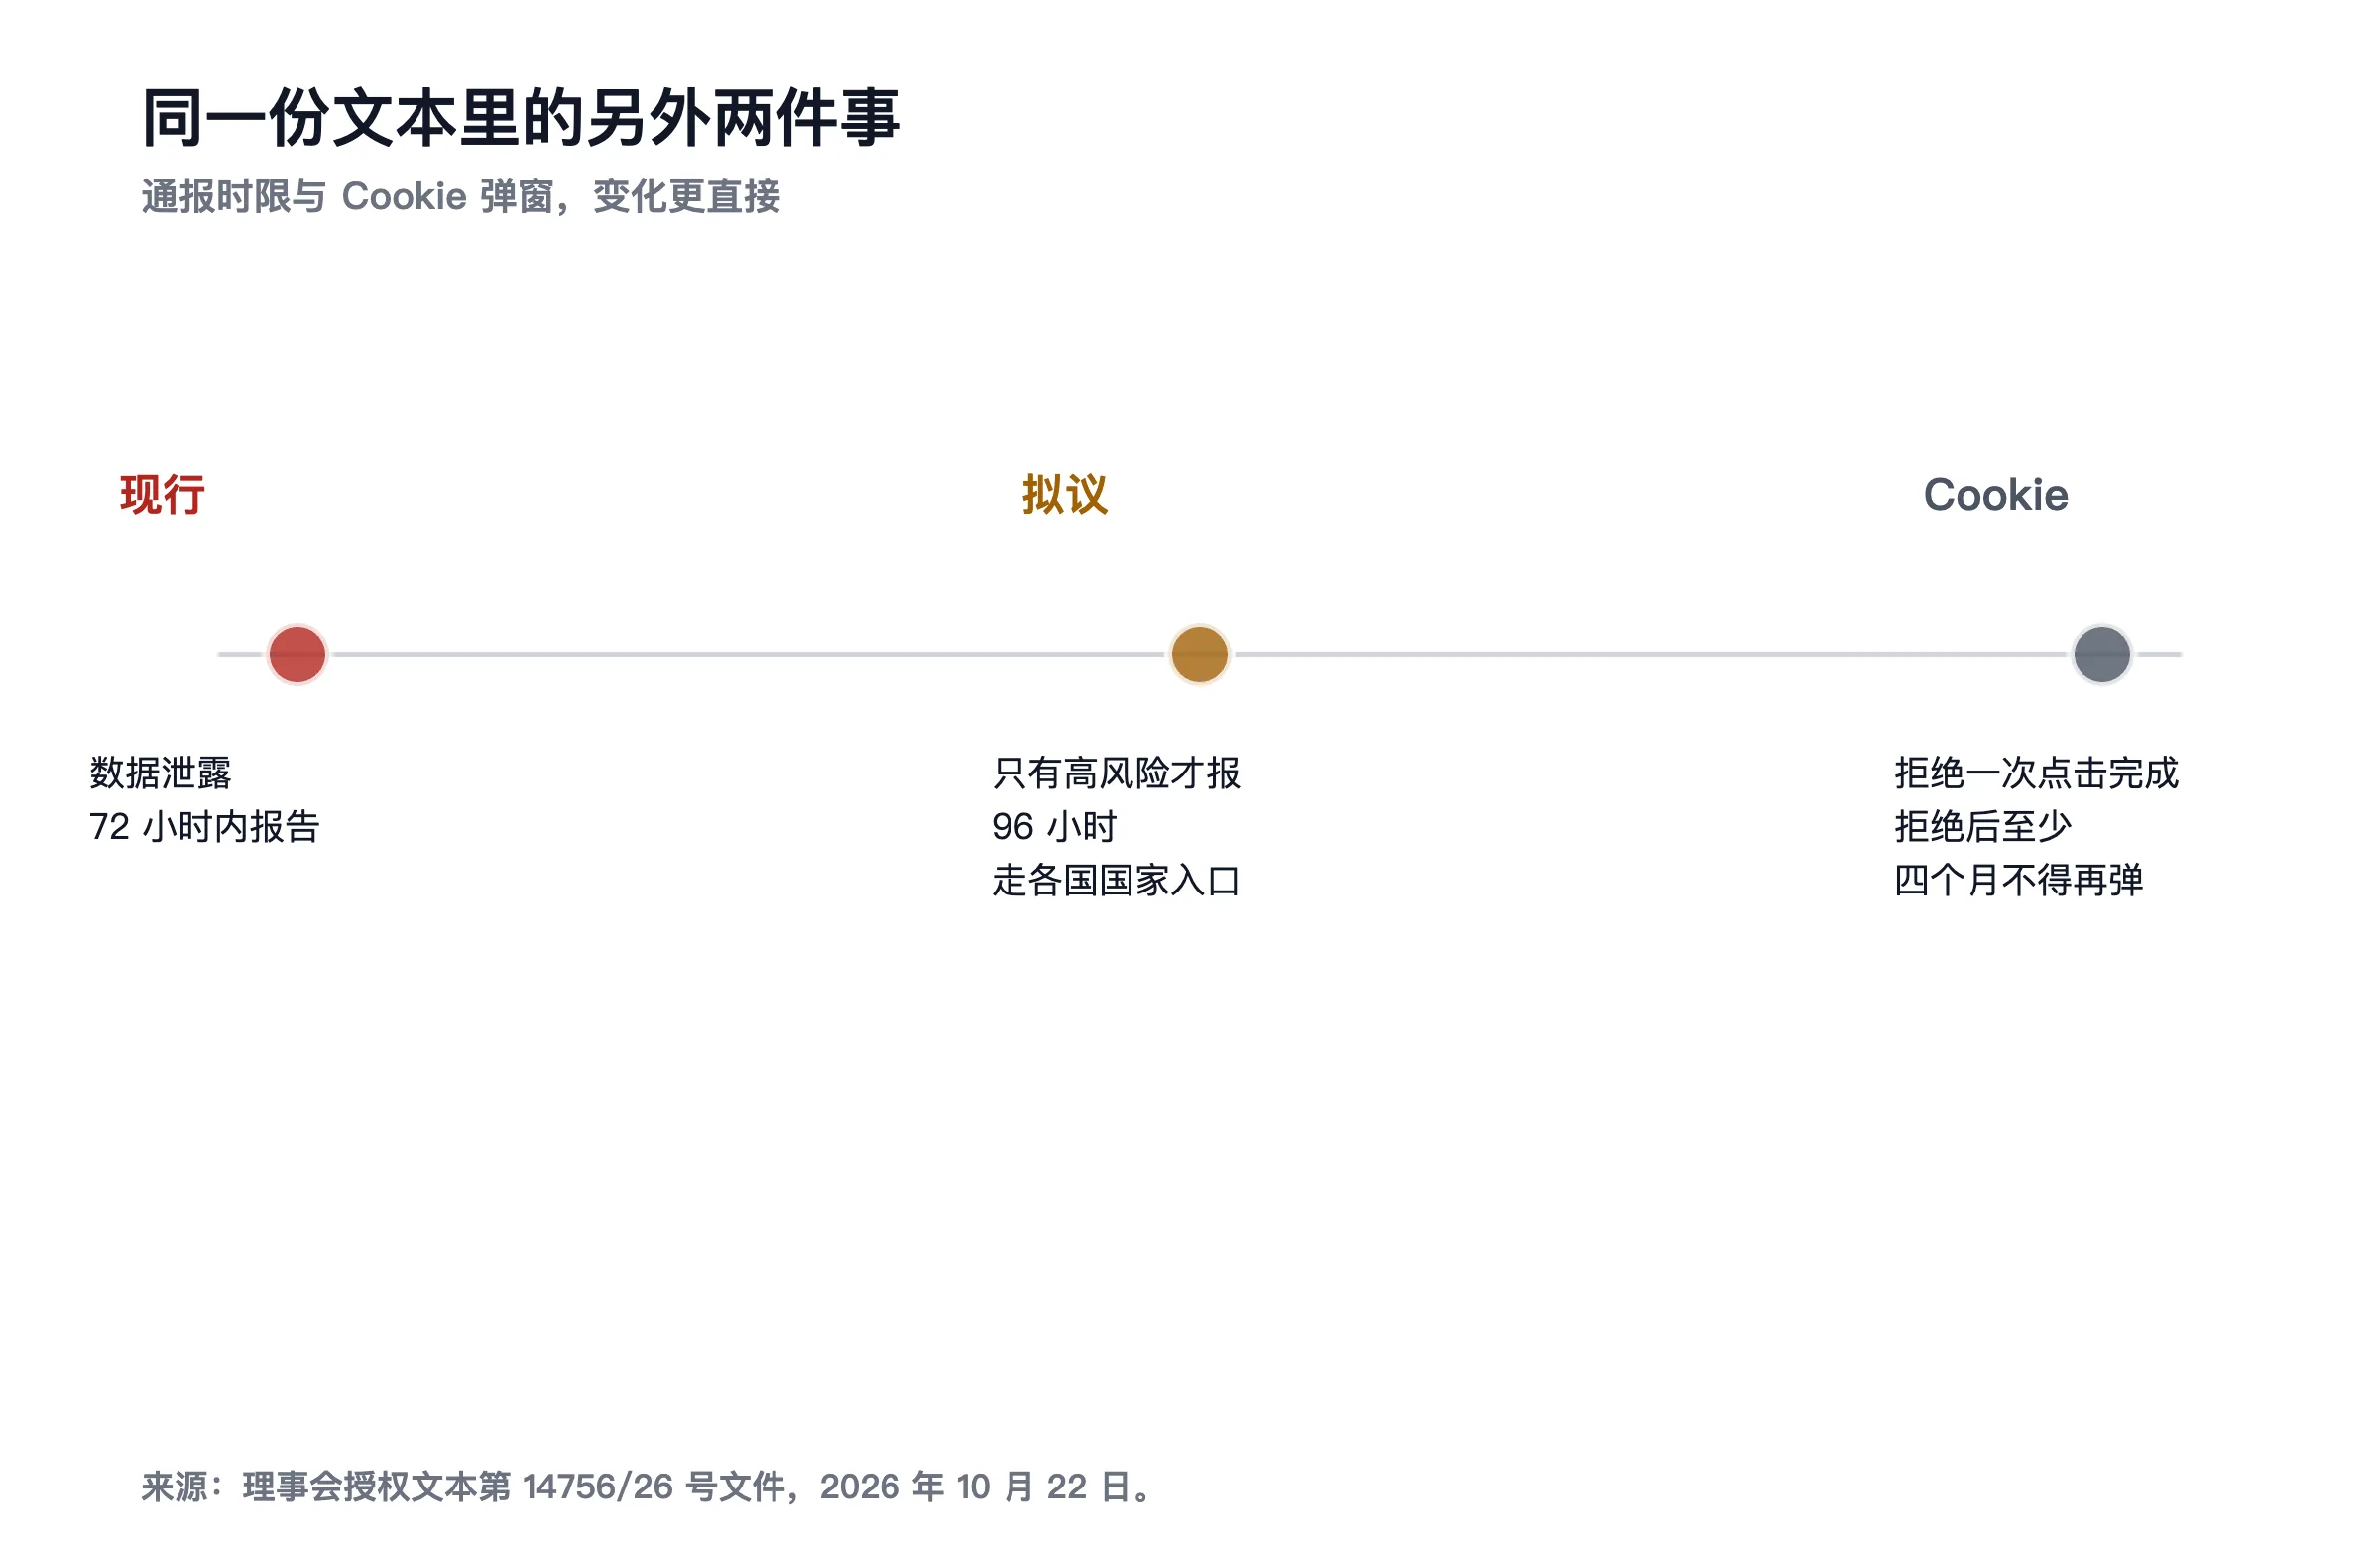
Cookie 规则继续留在 ePrivacy 指令框架里,但改写了第 5 条第 3 款:拒绝必须是"一次点击"就能完成;拒绝之后,同一个网站至少四个月内不得再弹一次同意框。另外扩大了不需要同意的情形,包括提供服务必需的、用于受众测量的、用于保护设备安全的。
如果这条最终落地,最直观的变化是:以后看到同意弹窗,点一次"拒绝"就真的结束了,不会再每周弹一次逼你点到同意为止。
第二件是数据泄露通报。
现行规则是 generally 在知悉后 72 小时内报告给监管机构。理事会的新文本改成:只有"高风险"的泄露才强制报告,时限放宽到 96 小时,并且走每个成员国的国家入口点,而不是委员会原本提的欧盟统一入口。
72 小时到 96 小时,看起来只差一天。真正的差别在前半句:只有高风险才报告。这意味着大量中等和低风险的泄露,不再进入监管的视野。
## 我怎么看这件事
我不打算把它写成"隐私没了"。那样说不准确,也不负责。
我认为真正改变的是默认值。
在旧的结构里,公司要处理一个人的数据,需要先找到一个法律依据,拿不出来就不能用。在新的结构里,AI 开发被预先放进了一个"可以"的格子里,反对的责任转到了个人身上:你不满意,你得自己去反对。
这个转向很小,但方向很清楚。从"需要理由才能用"变成"需要理由才能不用"。
对普通人来说,麻烦的不是法条,是举证位置变了。以前你默认不在训练集里,现在你默认在,除非你主动走出去。而"走出去"这件事,需要你知道自己在里面,需要你找到那个开关,需要你愿意花时间。
> 以前是"你凭什么用我的",以后可能是"我说过不同意吗"。
还有一层,跟我们这边也有关。国内的处理思路不一样,但问的是同一件事:已经公开的个人信息能不能拿来训练?最高人民法院今年发布的涉人工智能纠纷案件审理意见里给了口径:在合理范围内处理个人自行公开或已合法公开的信息、且个人未明确拒绝的,一般不认定为侵害个人信息权益;但对个人权益有重大影响的,仍应依法取得同意。
两边的表述不同,落点其实接近:公开不等于授权,但"合理范围"三个字留了很大空间。
## 这个月能做的五件事
第一件,把带脸的旧内容收一遍。
不用删账号,把可见范围从"所有人可见"改成"仅粉丝"或"仅自己"。重点处理 2015 到 2020 年那批,那时候大家发得最多、最不设防。
第二件,孩子的照片单独处理。
理事会文本里特意写了"尤其是数据主体是儿童时"。这一句说明立法者也知道孩子的数据更麻烦。别把孩子的正面照、学校、班级、作息发在公开账号上。已经发过的,删掉比设置更有效。
第三件,去翻一遍你常用的服务里有没有那个开关。
不少平台这两年在设置里加了"是否允许内容用于模型训练"之类的选项,通常藏在隐私或者数据那一层。有的给了开关,有的只给了一句说明。找不到开关的,可以按平台的隐私邮箱写一封,问三个问题:我的内容是否被用于训练、依据是什么、我怎么反对。
第四件,Cookie 弹窗以后只看一个按钮。
新规要求拒绝必须一键完成,并且四个月内不得重复弹。如果哪个网站还在用"拒绝"要你点三次、或者关掉又弹,那说明它在赌你不知道这条规则。截图留着,这条以后是可以直接投诉的。
第五件,留证据的习惯。
你公开发过什么、什么时候发的、平台当时的规则是什么,截一张图存着。这类事情将来真要较真,靠的是时间戳,不是记忆。
## 最后一句
我不认为所有人都要为此紧张。我也用 AI,我知道它确实需要数据。
我介意的是这件事发生的顺序:先拿走,再告诉你,然后让你自己去找那个退出按钮。
那就问一句:如果有一个更好用的 AI 摆在你面前,代价是你 2016 年发过的那些东西会被拿去训练,你会同意吗?
你也可以反过来想:这个选择,你有没有被正经地问过一次。
---
来源:
- 欧盟理事会新闻稿《数字规则手册:理事会就简化数据保护、隐私和网络报告规则的立场达成一致》,2026 年 10 月 21 日发布、10 月 22 日更新并附理事会授权文本,https://www.consilium.europa.eu/en/press/press-releases/2026/10/21/digital-rulebook-council-agrees-position-to-simplify-data-protection-privacy-and-cyber-reporting-rules - noyb 对理事会文本的评论,2026 年 10 月 23 日,经 PrivacySavvy 报道,https://privacysavvy.com/news/privacy/eu-personal-data-rules-ai-development - 理事会授权文本细节(第 25a 条、第 88 条之二、Cookie 四个月、96 小时通报),经 NicFab 第 44 期通讯整理,2026 年 10 月 27 日,https://www.nicfab.eu/en/newsletter-issues/2026-10-27-issue-44
资讯由采集器定时从公开的机器人 / AI 信息源自动聚合。
相关内容
一张电费单上,你看不出哪些是 AI 用的
2000 名得州选民、99% 的人认为建数据中心的公司该自己付电网扩建的钱,79% 支持限制数量。这个数字不分党派。争议不是要不要 AI,是 AI 的电凭什么记在家用账单上。
凌晨三点问出去的那句话,它答得像模像样
三份新研究第一次把 AI 的心理建议拆开打分:对焦虑的回答好过抑郁,中度好过重度;你说「我不想找人」之后,只有 2% 的回复会追问一句为什么。
投了两百份简历,没有一个活人跟我说过话
2832 名求职者的调查里,81% 的人过去一年有工作是在没跟公司里任何一个人说过话的情况下被拒的。77% 用了 AI,60% 又改写法以免被当成 AI。沉默正在变成招聘的默认设置。
半夜两点,她在跟一个不会困的东西说话
21 所学校、5500 多名学生的调查显示,57% 的孩子在难过、孤独或撑不住的时候会打开 AI,跟用它写作业的比例几乎一样高。同一周,另一项测评发现,家长那头的警报一次也没响。
孩子饿得直哭,门锁打不开,电话里只有一句「亲」
智能锁坏了,一家三口被关在门外 50 分钟,电话里只有循环播放的话术。转人工难不是技术跟不上,是企业把 AI 当成了过滤网。附一份今天就能用的『找到真人』清单。

你家空调调到几度,正在被一座数据中心决定
AI 算力第一次这么直接地落到普通人账上:不是股价,不是新闻,是这个月的电费单。