AI 把活干完了,我却交不出去:这两周八次选工具的记录
2026 年 11 月 8 日回看过去两周:八次工具选型,每组都摆出候选对比表、实测结果和最终定下来的名字。ImageGen、Apache ECharts、hotspot-radar 都在里面,连淘汰的也点名。结论有保质期,隔一个月该重问哪四句也写了。
本文目录10
这篇写在 2026 年 11 月 8 日。翻过去两周的工作记录,从 10 月 26 日到今天,为了把几批文章和图真正交出去,我们前后换了八次工具。
不是攒了几年的经验,是这两周刚踩完的坑。所以下面每一组都按当时的顺序写:先是怎么想的,再把候选摆在一起实测,最后给一个定下来的名字和它的适用边界。版本也标了。这类结论有保质期,工具一更新就得重跑。
第一件事出在配图上。对话里生成了一张挺好看的图,构图干净,颜色也对。问题只有一个:它只在这个对话窗口里。文章第二天要发,配图得是一个能上传的文件。
一位普通人深夜坐在书桌前,面对屏幕上刚生成的内容,神情犹豫
题图:要的是文件,不是画面
当时手边四类工具。按功能排,buddy-multimodal-generation 管三维和模板视频,VideoGen 做视频,show_widget 画对话内矢量图,听着都比老老实实文生图的 ImageGen 先进。真跑一遍才发现,比较的维度从一开始就选错了:该问的不是谁画得好,是谁交得出东西。
| 候选 | 实测交出来的东西 | 判定 |
|---|---|---|
ImageGen | 一个能落盘的图片文件 | 选它 |
show_widget | 对话内的 SVG/HTML,刷新就没 | 淘汰,输出不在磁盘 |
buddy-multimodal-generation | 3D 模型、模板图生视频 | 淘汰,不是静态图 |
VideoGen | 视频片段 | 淘汰,不是静态图 |
最后定的是 ImageGen。不是画得最好,是只有它交得出文件。后面压缩、转 WebP、生成缩略图,一路能接着往下走,中间不用人再伸手。
边界也写清楚:只想在对话里演示一下,show_widget 反而最快。三种交付物三种工具,混着比,比一天也出不来结论。这条是 10 月底补进流程的,当时只是隐约觉得哪里不对。
角标:先关源头,擦除留兜底
麻烦跟着就来。ImageGen 出的图,右下角带一个小小的标记。我们花了不少力气比「怎么擦得更干净」,直到几天后发现生成接口本来就有个 footnote 参数,传空值,标记大多能从源头不出。
| 办法 | 实测表现 | 判定 |
|---|---|---|
| 图生图重绘 | 顺手把人物和背景一起改了 | 淘汰 |
| 像素硬补 | 复杂纹理上留一块痕 | 淘汰 |
buddy-image-processing 的 erase | 只擦那一小块,别的地方不动 | 留着兜底 |
生成时传 footnote: "" | 多数模型不再出现角标 | 优先用,但不保证 |
最后定的是两条都留:源头关闭 + erase 兜底。 我差点把结论写成「以后不用再擦了」。11 月初换过一次模型,footnote: "" 又失灵,角标照样在。这句幸好没写进流程。
更值钱的问题原本是能不能让角标一开始就不出现,而不是擦除技巧。那天我们对着一批图一张一张擦了半个钟头,才回头去翻参数。
知识图:字是事实,不能交给模型
配图这一步也改了做法。先拆文章:讲了哪几个知识点,哪些是结构,哪些是时间顺序,哪些是观点对照,哪些是数字。拆完按知识点出图。
一拆就发现,大部分图里其实要写字。中文,数字,来源。ImageGen 会把字写错,会把数字凑得挺像但根本不存在。图可以抽象,字不行。
| 候选 | 实测表现 | 判定 |
|---|---|---|
ImageGen 直接写字 | 中文错笔画,数字看着像但对不上原文 | 淘汰 |
antvis/Infographic | 声明式 SVG,中文无损,模板偏卡片 | 不够通用,进下一轮 |
| mindmap 类模板 | 只适配树状结构 | 不适合作通用方案 |
contextweave-interactive-architecture | 交互式架构图,交付物不是静态图 | 淘汰 |
自建 render-charts.mjs | 结构图、时间线、观点对照、数据卡全由 spec 驱动,中文清楚、数字从数据搬 | 选它 |
最后定的是确定性渲染,落到自建 render-charts.mjs。生成式图像只留一个位置:需要点氛围、画面里一个字都不用写的概念封面。确定性渲染还天然没有角标。
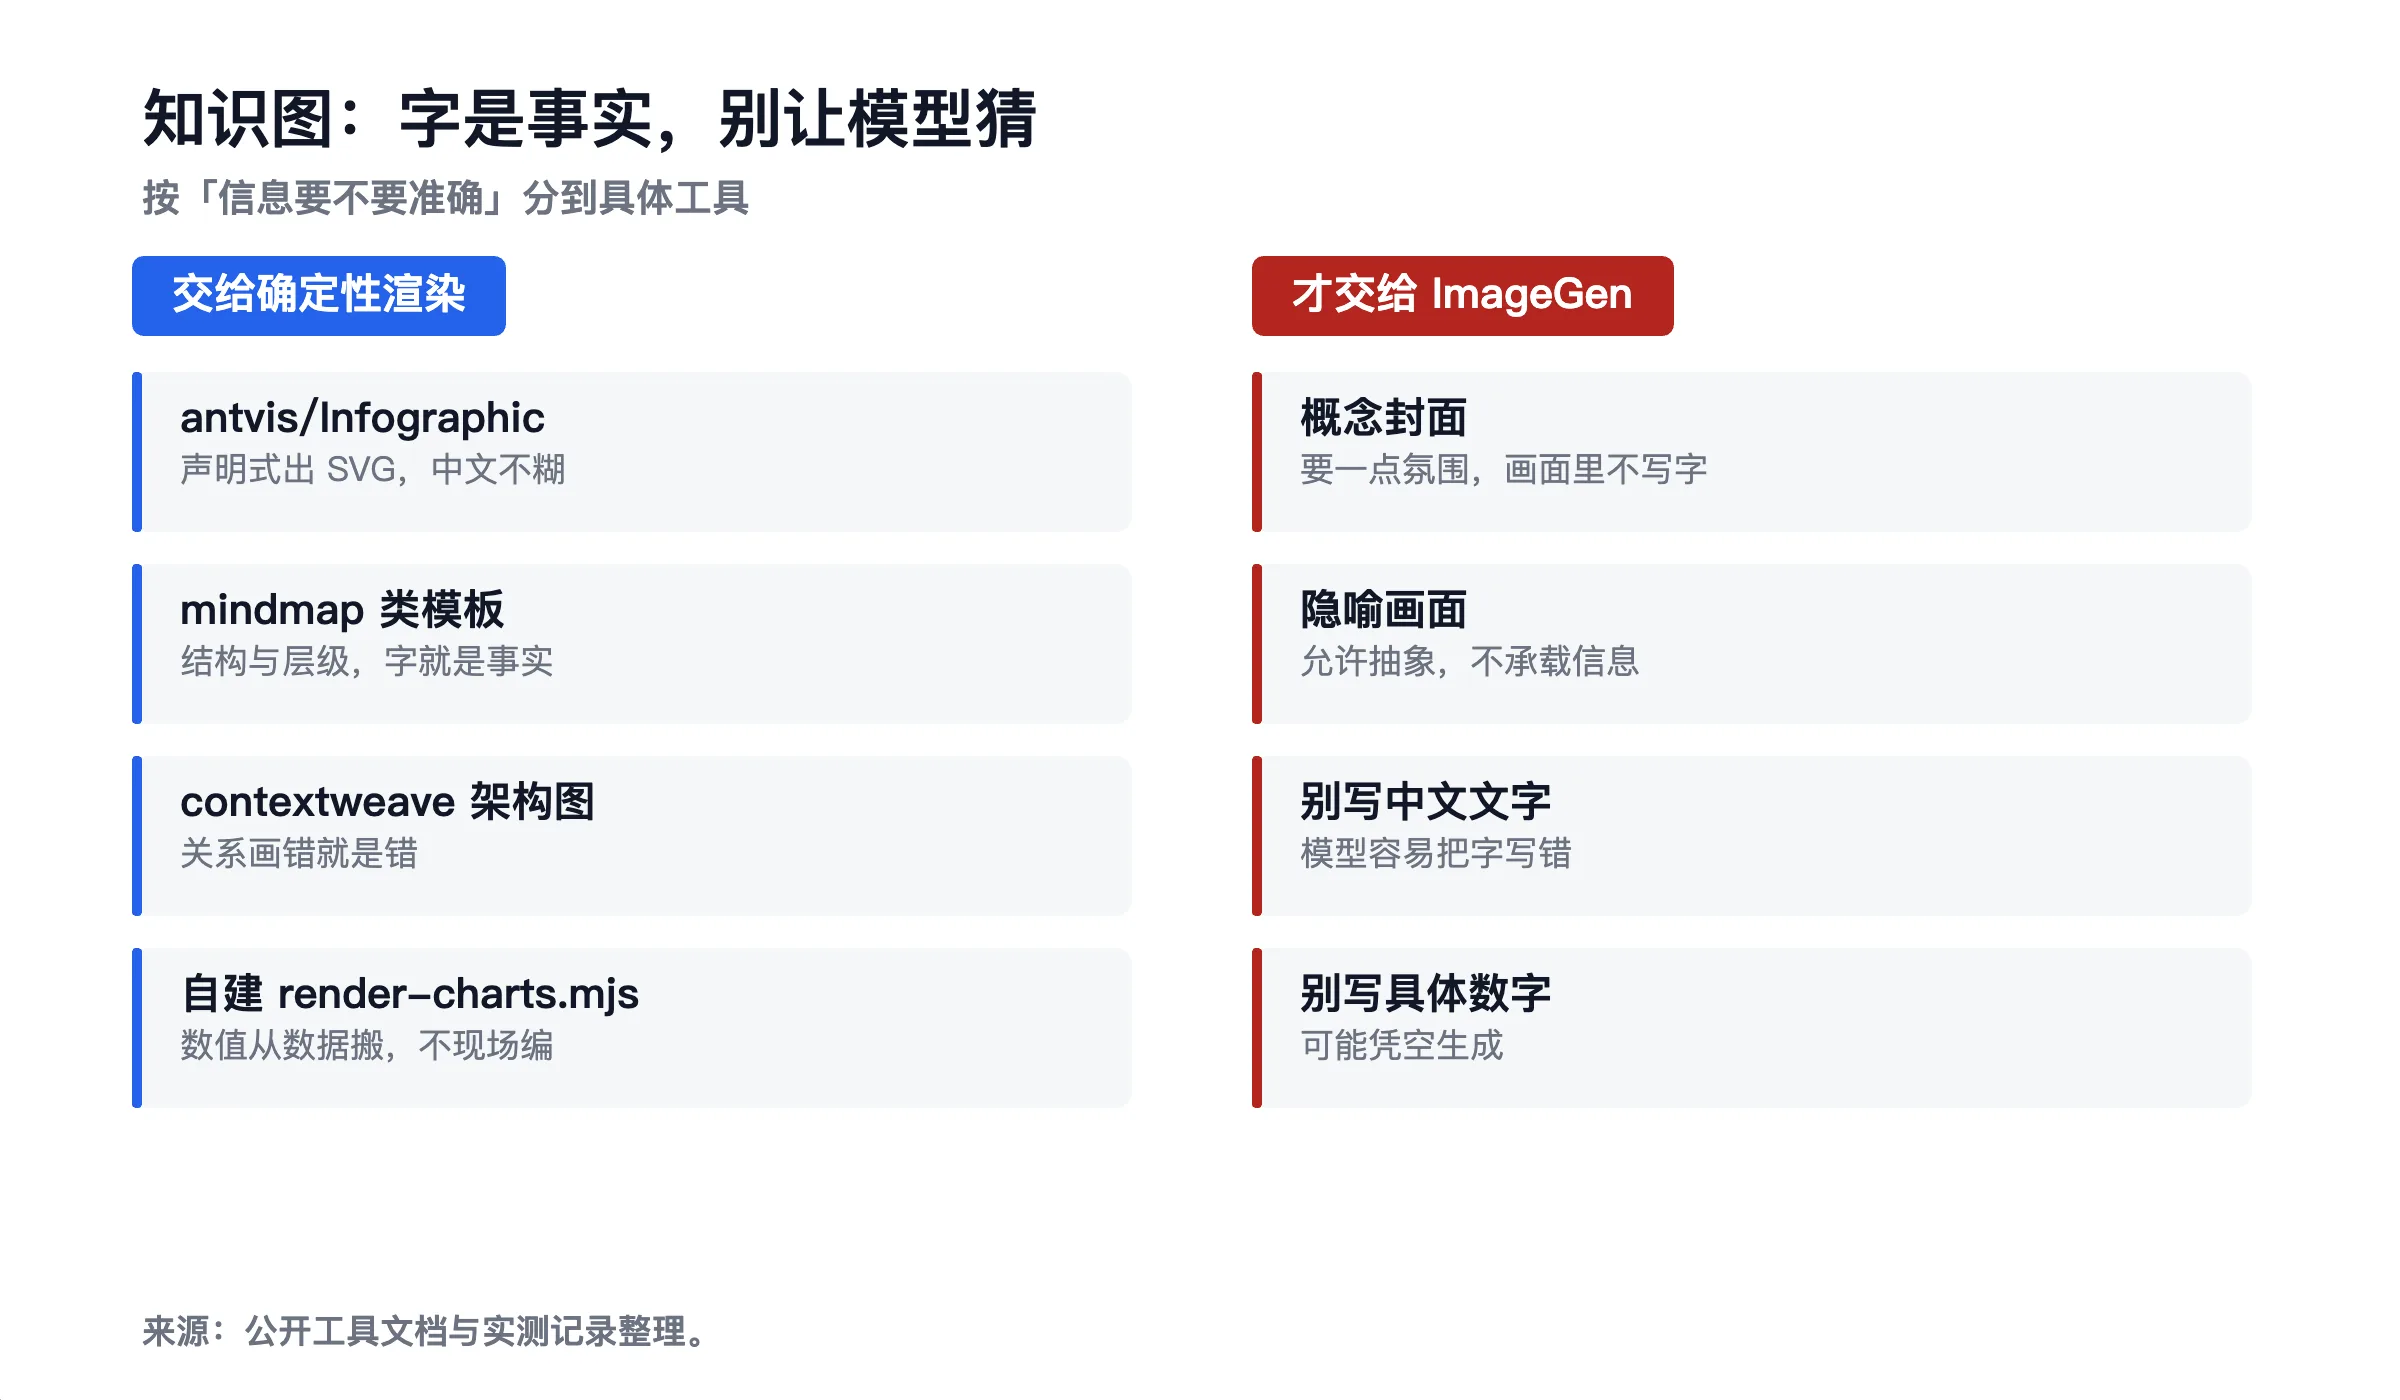 知识图按「信息准不准」分流:确定性渲染与生成式图像各自的分工
数据图引擎:从卡片换回长度
这一轮多走了一次回头路。10 月底在 GitHub 上读完原文,先选的是 antvis/Infographic:声明式语法输出 SVG,中文原样渲染,看着挺对。真跑出来才发现,它的卡片模板把数值写成文字,一个个排在卡片里,很好看,但得「读」。
同一组数值,只问一句「哪个大」。条形和点阵不用读,眼睛扫一下就知道;卡片得一个个数过去。于是 11 月初又比了一轮。
| 方案 | 实测与取舍理由 | 判定 |
|---|---|---|
apache/echarts | bar、scatter 自带长度与数量编码,SVG 矢量,中文没麻烦 | 选它 |
antvis/Infographic | 中文无损,但卡片模板没有视觉编码,还有丢值、挤压的坑 | 换掉 |
vega/vega-lite | 可复现,无头浏览器里的中文字体更折腾 | 淘汰 |
antvis/G2 | 图形语法强,版本迭代快、配置繁琐 | 淘汰 |
observable/plot、d3 | 拿来画常规柱状图属于过度工程 | 淘汰 |
最后定的是 apache/echarts。换完之后,所有图都由一份 spec 驱动,后面再出图不用重写脚本。判定标准写进流程:没有长度或者数量在替你说话的,不算数据可视化。
顺手踩了两个坑,都是这两周实测出来的。ECharts 的 graphic 数组没有 series 时会报错,得换成散点加自定义图形;配置经过序列化传进页面时,写在回调里的颜色会静默丢掉,只能写进每个数据项。工具越简单,越容易在边角上翻车。
是非题别用柱子
有一张图内容是「首批支持什么、暂不支持什么」。当时顺手用了那份脚本里的 bar:支持的画满格,不支持的画空格。整整齐齐,也整整齐齐地错了。
条形的长度天生在说「多少」。读者看见两根一样长的满格,冒出来的不是「有」,是「很多」。可那栏里根本没有数量,只有是和否。
| 图型 | 实测读法 | 判定 |
|---|---|---|
bar | 满格/空格被读成数量对比 | 淘汰于二元对照 |
pictogram | 点阵同样带数量语义 | 留给数量题 |
新增 checklist | 两列清单,一边「有」一边「没有」,每行一件事 | 选它 |
最后定的是二元对照一律用 checklist,后来也能用在「怎么测的/测出了什么」这种非二元双列上。清单本身还改了三处:列头宽度按文字自适应,否则长标签被切;行高按可用高度算,否则最后一行压到底部来源说明;图底部 note 一律压成一句话,写长了右侧会被截断。
先想清楚这张图在比数量还是判是非,再选图。别倒过来。
三语去 AI 腔:先淘汰取向不对的
写稿这一环比得最久,也最花冤枉时间。要的是把 AI 腔去掉。中文先比 blader/humanizer 和 op7418/Humanizer-zh:前一个名气大,规则全是英文的,破折号、连字符那一套,对中文基本无效;后一个含中文专检,叠「的」、「进行+动词」、被字句、四字排比、「随着…发展」,才是中文稿里真正碍眼的东西。
英文和法文翻到五个开源候选,逐个把 SKILL.md 原文读完。我一开始按厚薄排,越厚越好。读到第三个才觉出不对:该问的不是厚不厚,是它到底想解决什么。
| 候选 | 它实际优化的目标 | 判定 |
|---|---|---|
blader/humanizer | 英文破折号、连字符等 | 淘汰,中文不对症 |
op7418/Humanizer-zh | 31 条中文 AI 腔特征,含中文专检 | 选它,固化为 feng-style-writing |
samber@humanizer-en-asd-ste100 | ASD-STE100 技术英语,维护手册的无歧义 | 淘汰,叙事稿会写成说明书 |
amineall/human-writing-skills | Pangram、GPTZero 等检测器的过检率 | 淘汰,目标不是好不好读 |
kambleakash0@english-humanizer | 几页极简清单 | 淘汰,撑不起长文 |
jpeggdev/humanize-writing | 八遍编辑流程 + AI 腔特征清单,明写「不是要把文章写笨」 | 选它,固化为 plain-style-writing-en |
samber/cc-skills 里的 humaniseur-fr | 38 条法语专属腔调与排版,含弯撇号、空格、引号 | 选它,固化为 plain-style-writing-fr |
最后定的是三语各用各的母语包:feng-style-writing / plain-style-writing-en / plain-style-writing-fr。装上也只是底座,真能用的是又叠了一层:这篇要多少字、标题怎么排、哪些数据必须回原文核一遍、写成什么样算不合格。外部清单管通病,自家这层管我们这儿的规矩,参考过 agentskills.io 的技能包组织方式。
这类工具最容易挑错的地方,不是不够强,是方向跟你不一样。装之前花十分钟读原文,比装完再试三天划算。三天我们真试过,是 10 月底那批稿子。
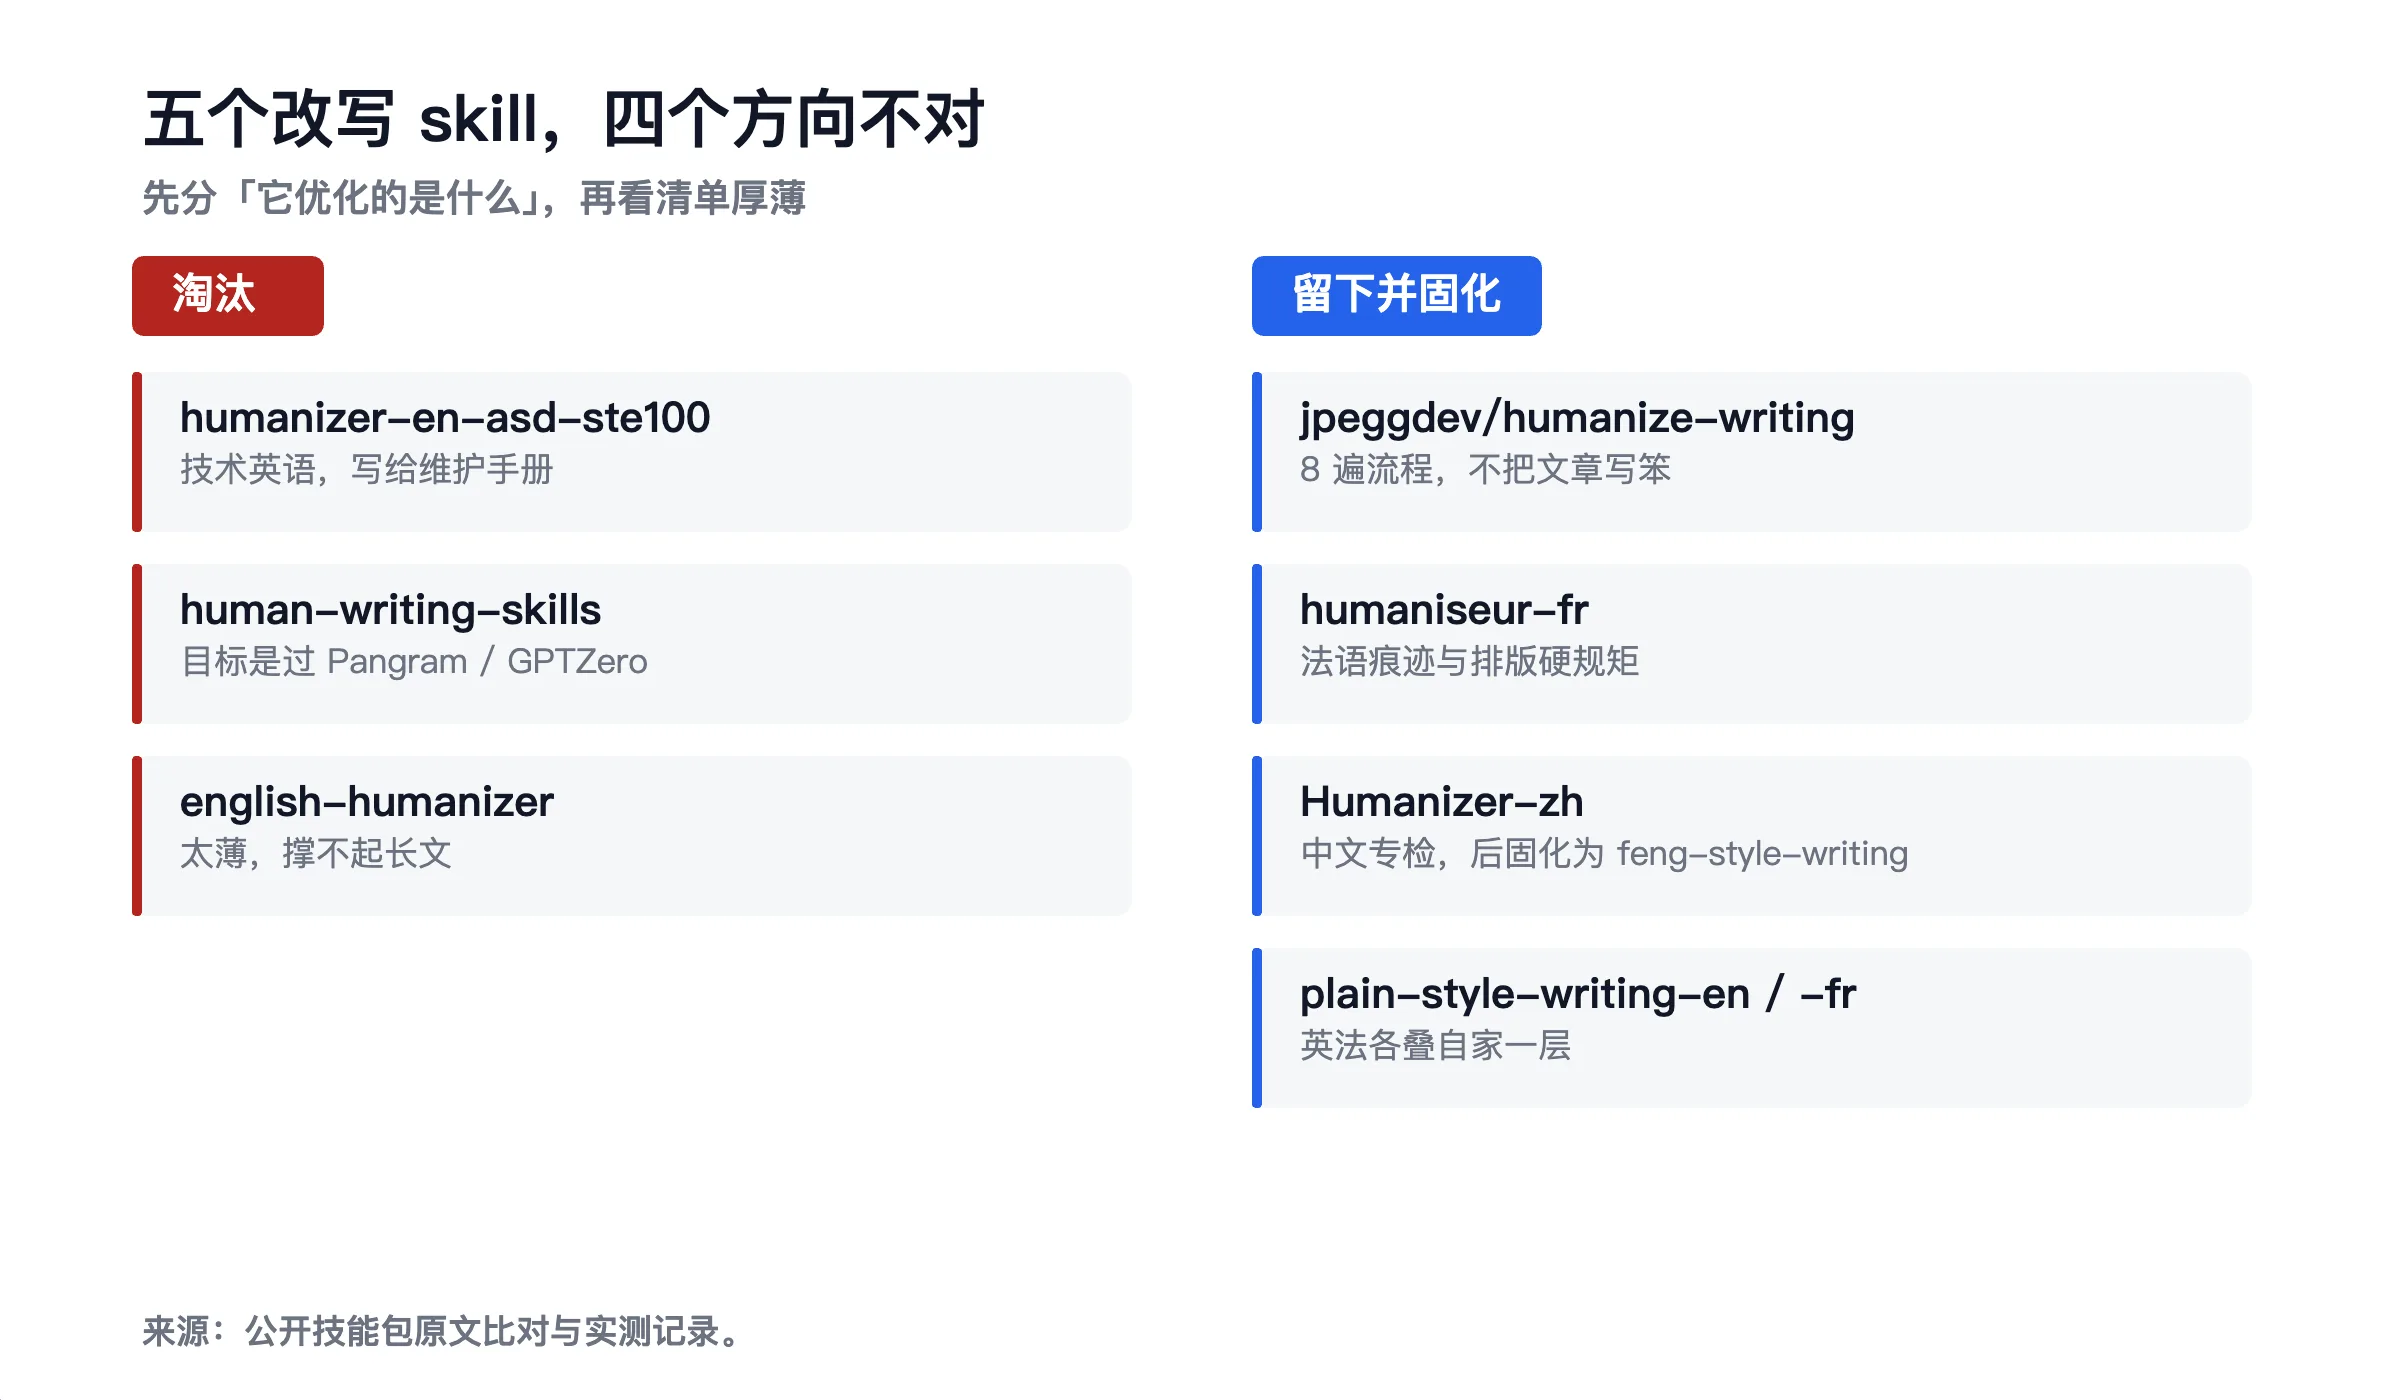 三语 humanizer 的取舍:点名淘汰技术英语与反检测器,留下母语清单再固化
热点抓取:自检说能用,实测说不通
11 月初装过一个挺完整的抓取工具,agent-reach v1.3.0。它的 doctor 自检列了一串「可用」通道,看着挺省心。我们按清单一条一条发真实请求,一下午就试完了。
| 通道 | 实测结果 | 判定 |
|---|---|---|
r.jina.ai 网页全文 | 连接超时(doctor 说可用) | 划掉 |
| TLDR AI | 卡在 Vercel 安全检查点 | 划掉 |
| The Register | 先要过工作量证明挑战 | 划掉 |
| 某中文站订阅地址 | 返回整个网页,不是订阅格式 | 划掉 |
| Reddit、X | 需要登录凭据,按口径直接跳过 | 不用 |
| 标准 RSS/Atom、GitHub、YouTube、公众号 | 稳定可用 | 进源清单 |
这里面没有谁在撒谎。自检大概只能测「配置齐了没有」,测不了「对面今天让不让你进」。可那一列绿色对勾实在太像答案了。
最后定的是自建 hotspot-radar:源清单写死、并行抓取、同一个事件被两处以上独立提到才算热点、第三方已经整理好的源加权更高,再按三条标准打分,跟普通人有没有关系、技术上的变化是不是真的重要且讲得明白、够不够新。通不过实测的通道直接从清单里划掉,不追根因。判定标准和通道清单后来写进一份 SKILL.md,下次不用重新试一遍。
这一步最大的提醒不是「自建更好」。是别把工具的自我报告当成事实,哪怕只花五分钟,亲手发一次请求,结论就可能反过来。只临时看一两个页面时,agent-reach 其实更轻,没删。
抓取分工:不设通吃
顺着抓取往下,还比过一组更杂的:一体化的 agent-reach、能复用浏览器登录态的 zhihu-cdp-scraper、MediaCrawler 旧版和新版,还有直接用浏览器读单页。一开始想找一个能全包,比完放弃了。
| 采集深度 | 用谁 | 为什么 |
|---|---|---|
| 关键词全量检索 | 覆盖广的那一手,MediaCrawler 新版补上了关键平台支持 | 要的是找全 |
| 历史长文、需要登录态 | zhihu-cdp-scraper | 能带着登录态翻旧账 |
| 单篇归档、零散页面 | 浏览器直连 | 随手点开就能看,不进固定流程 |
| 每天筛一批热点 | 自建 hotspot-radar | 量上来了、接口稳了才固化成脚本 |
| 临时看一两个网页 | agent-reach | 不为它搭一套聚合流程 |
最后定的是按场景分工,不统一品牌。旧版 MediaCrawler 缺几个关键平台支持,新版补上,也就只在那一类活里用。找全、翻旧、存一页、随手看,这四件事的「好」根本不是同一个标准。等某一类采集的量真上来了、接口也稳了,再单独把它固化成脚本,hotspot-radar 就是这么来的。不提前统一。
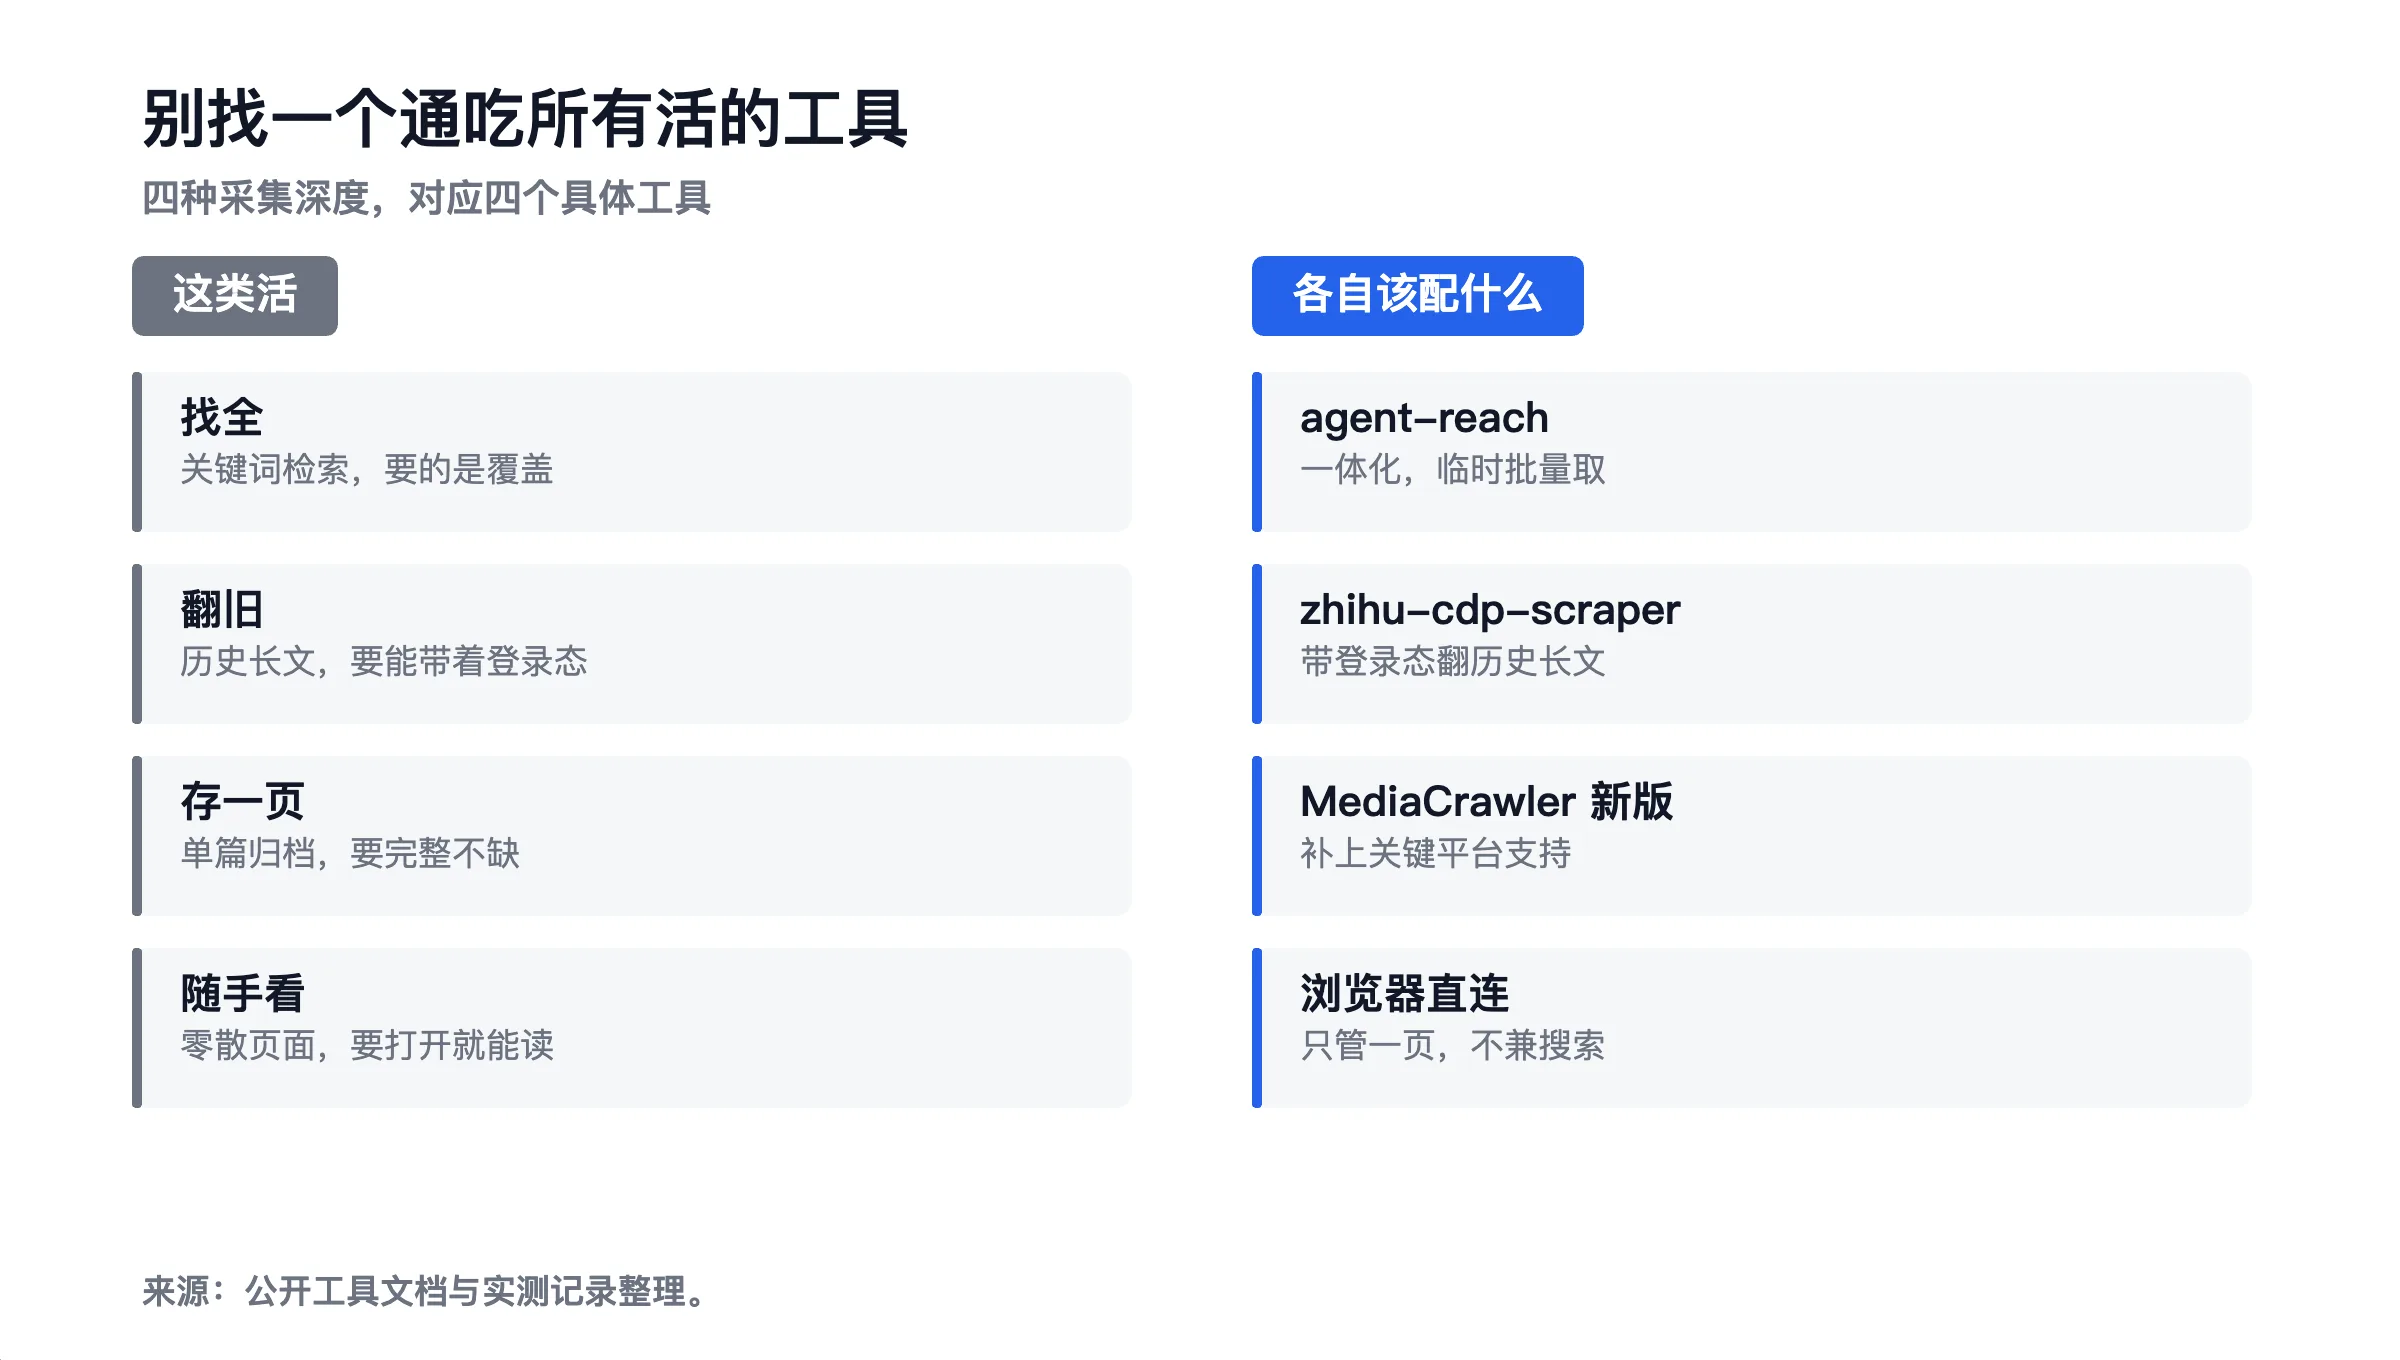 抓取工具按场景分工:agent-reach、zhihu-cdp-scraper、MediaCrawler 与浏览器直连各管一段
把名字抄走
前面是八次怎么想。要是你现在就动手,这一张表按 2026 年 11 月 8 日的版本核对过,直接复制。
| 你要做的事 | 用这个 | 别用 |
|---|---|---|
| 一张能随文章发出去的静态图 | ImageGen,生成后转 WebP | show_widget、VideoGen |
| 图右下角有角标 | 生成时传 footnote: "";还在就用 buddy-image-processing 的 erase | 图生图重绘,会改画面 |
| 图里要写中文、数字、来源 | 自建模板加 apache/echarts | ImageGen 写字 |
| 让读者一眼比出大小 | apache/echarts 的 bar / pictogram | antvis/Infographic 卡片模板 |
| 表达支持/不支持、有/没有 | checklist | bar |
| 中文稿去 AI 腔 | feng-style-writing | 直接套英文 humanizer |
| 英文/法文稿去 AI 腔 | plain-style-writing-en / plain-style-writing-fr | amineall/human-writing-skills |
| 每天筛一批热点 | hotspot-radar | 只看工具的 doctor 自检 |
| 只临时看一两个页面 | agent-reach 或浏览器直连 | 为它搭一套聚合脚本 |
判断就一句:输出不在磁盘上,直接淘汰,不比画质。
别一次全换。挑你手上返工最多的那一环,照着对应那行先换一个,跑通再往下走。这八次里没有一次是同时换掉整条链路的。
这些结论的保质期
写于 2026 年 11 月 8 日,实测窗口 10 月 26 日到今天。名字会变:agent-reach 现在是 v1.3.0,MediaCrawler 有新旧两版,footnote 也不是每个模型都认。隔一个月回来,别照抄结论,把这四句重问一遍。
它交出来的是什么? 一次好看的演示,还是一个能直接发出去的文件。这两件事经常被混成一件事,只有后者算交付。
有没有人真的试过? 文档写的、自检报的、别人说的,都算线索,不算结果。拿一个最小样本跑一遍,五分钟就够。
第三句是我后来补的,也最容易被跳过:它优化的目标跟我要的一样吗?技术英语规范和反检测器清单都很完整,只是它们要的东西跟我们不一样。
第四句关于退路。新工具上线那天,旧办法最好还留着。我们后面能放心换,不是每次都选对了,是每次都留了退路。
还有一句,别急着让它统管全部:一个工具在某一环特别顺手,不代表它在下一环也顺手。以及——如果一个环节要靠不断优化补救才能用,先停下来问问,能不能让这个补救从一开始就不必要。关掉那个角标,比学三种擦除办法都值。只是 footnote 不是每次都灵,兜底还得留着。
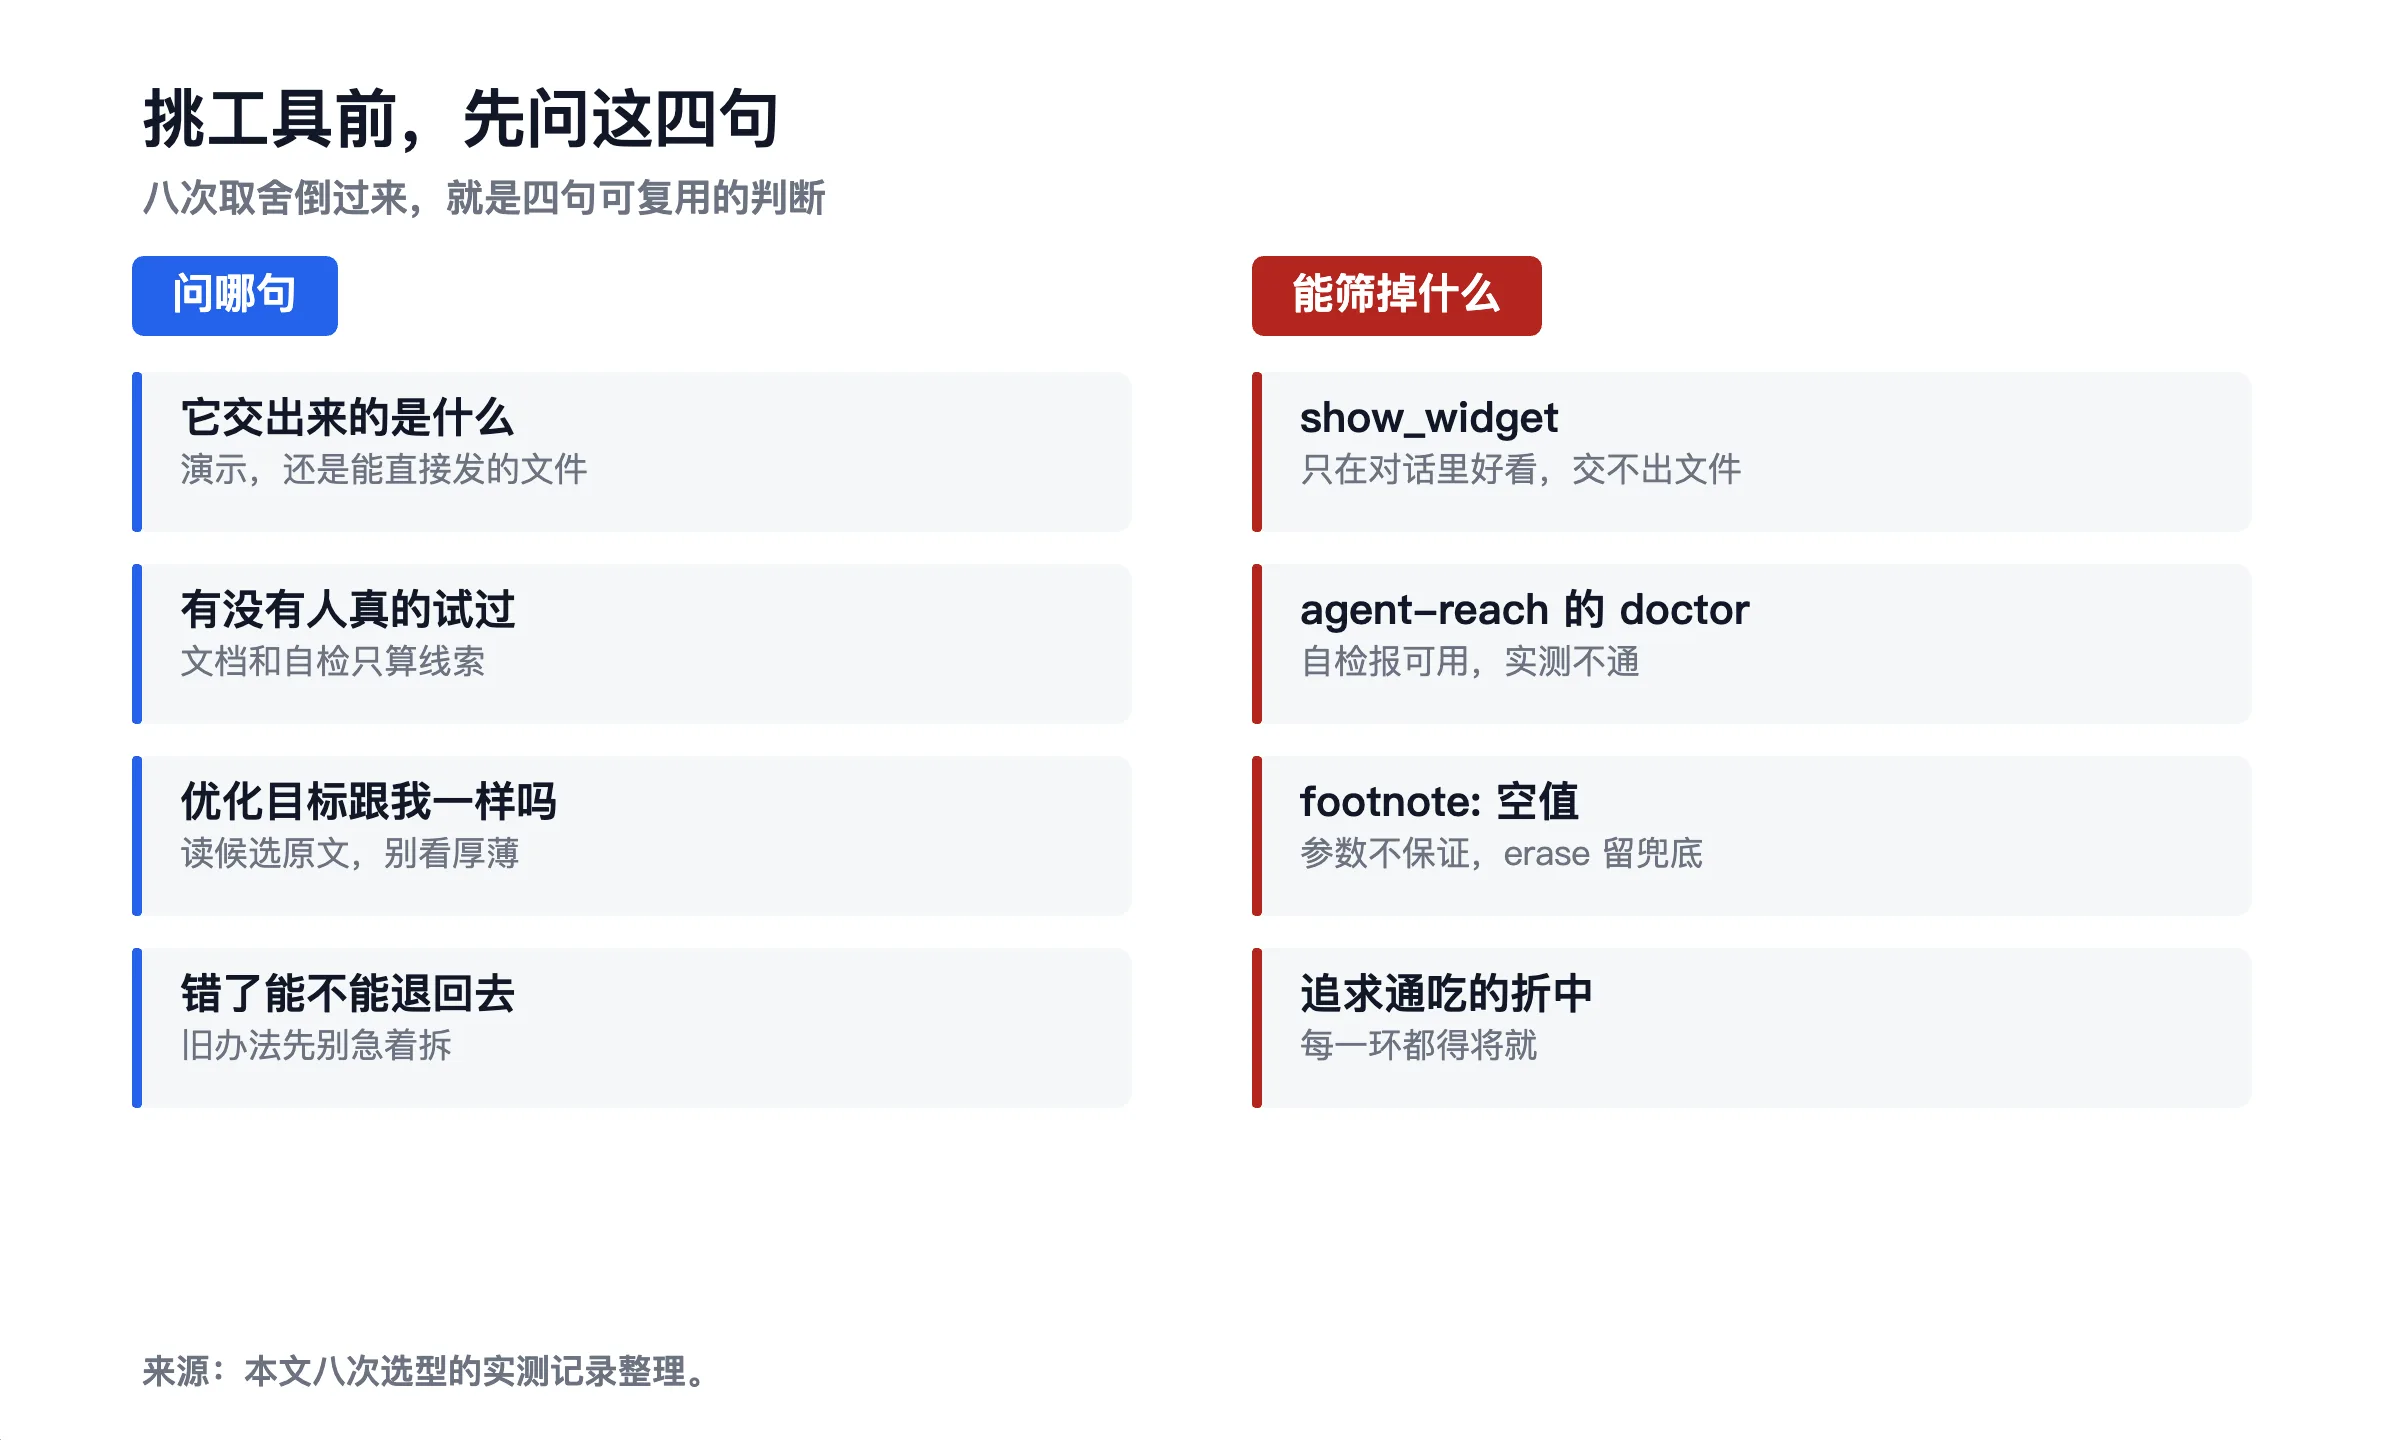 挑 AI 工具时可以先问的四句话,以及每句话能筛掉什么
工具变强是别人的事。你手里那件活能不能交出去,才是你的事。
参考来源:apache/echarts、antvis/Infographic、vega/vega-lite、antvis/G2、blader/humanizer、op7418/Humanizer-zh、jpeggdev/humanize-writing、samber/cc-skills、agentskills.io 等公开项目文档,以及 2026 年 10 月 26 日至 11 月 8 日八次选型的实测记录。文中不涉及任何内部系统、账号与业务数据。
你有没有过那种「AI 做得挺漂亮,可我就是没法直接用」的时候?最后是怎么绕过去的?
相关阅读
AI 前瞻
同一份模型,欧洲一边偷偷测,一边发了合规证书
10 月 9 日起,欧盟网络安全局和联合研究中心把中国开源模型关进不联网的机器里测;同一个月,西门子在用它们,第三方机构给自托管的 DeepSeek 发了「符合欧盟采购标准」的评级。10 月 26 日 Cohere 又发现 Qwen 一边写着「不调用工具」、一边往北京发测试串,Check Point 三天后重放 64 次得到 52 个不同地址。这半个月国外吵的其实是一句我们自己也信过的话:把模型下载到自己机房,数据就出不了门。
你的 iPhone 等了两年的那个功能,12 月真的来了
10 月 31 日,苹果官宣 Apple 智能 12 月随 iOS 27.3 落地中国,国行用户等了两年半。但缺席的不只是 Siri AI——新 iPad、Mac 也用不上,iPhone 15 标准版直接被挡在门外。真正能改变日常的,是千问进了 Siri、写作工具和视觉智能。
一张电费单上,你看不出哪些是 AI 用的
2000 名得州选民、99% 的人认为建数据中心的公司该自己付电网扩建的钱,79% 支持限制数量。这个数字不分党派。争议不是要不要 AI,是 AI 的电凭什么记在家用账单上。