空气动力学、碰撞都能模拟:谷歌Genie 4来了,把物理写进世界模型!
智东西
编译 | 杨京丽
编辑 | 李水青
智东西10月28日消息,今日,谷歌发布新一代世界模型Genie 4。该模型具备更强的 真实感和实时交互能力 ,能够在生成世界的同时, 原生生成音乐、环境音和交互式对话 。
▲谷歌发布最新世界模型Genie 4(图源:X)
谷歌称,Genie 4 融合了Gemini系列模型的能力 :Gemini Omni负责让模拟环境 在外观和行为上贴近现实世 界,其他Gemini模型则提供复杂 推理能力 ,帮助模拟世界保持连贯性和连续性。
用户可以在Genie 4中启动事件,模型会模拟事件发生后的过程,包括世界如何响应、环境如何发声,以及其中的人物如何移动、反应和说话。
谷歌CEO桑达尔·皮查伊(Sundar Pichai)在社交平台X上发文称,Genie 4是谷歌目前 “最逼真、交互性最强的世界模型” 。他提到,Genie 4可以实时操控动态环境,生成与场景匹配的原生音频,还能借助Gemini的推理能力生成更连贯的多步骤事件。
▲皮查伊发文介绍Genie 4(图源:X)
2025年8月,谷歌发布上一代世界模型Genie 3。相比之下,Genie 4加入了原生音频、实时人物对话,以及由Gemini模型提供的 多步骤推理和场景控制能力 。同样提示词下,Genie 4生成的场景更具真实感,人物的动作也更为自然。
部分开发者认为,Genie 4让实时世界模型有了 “置身片场”的感觉 。用户可以进入一个实时运行的模拟场景,连续录制多次“拍摄”,并即时调整摄像机角度、灯光、声音和人物动作。
▲海外开发者对Genie 4的评价(图源:X)
还有人认为,Genie 4可以让外界看到 世界模型接近AGI的潜力 。通过将Genie与Gemini结合,Gemini可以观察模拟过程,把目标拆解为更简单的步骤,并随着世界变化调整计划。未来,语言模型的推理能力如果与世界模型学习到的物理规律结合,Agent或许可以先 在模拟环境中测试行动、比较结果 ,再将方案应用到现实世界,从而提升空间和物理推理能力。
▲海外开发者对Genie 4的评价(图源:X)
谷歌认为,理解和模拟现实世界是 构建AGI(通用人工智能)的重要环节 。Genie 4希望生成安全且可无限变化的模拟环境,为机器人和Agent提供训练场景,同时支持创作新的交互式体验。
目前,Genie 4已经以研究预览的形式,向受信任的测试者逐步开放,在面向消费者和开发者发布之前收集反馈。后续,Genie 4将首先面向Project Genie中的Google AI Ultra订阅用户,以及Gemini API和Google AI Studio的早期接入合作伙伴开放。
一、支持自然语言实时操控,场景可同步生成环境音
使用Genie 4时,用户可以通过自然语言实时修改模拟环境,例如改变天气、移动摄像机,或者加入新的角色和物体。Gemini会结合周围场景理解用户指令,使修改内容与原有环境保持一致。在用户两次输入之间,Gemini还会持续观察并引导场景发展,让世界保持连贯推进。
官方案例中,模型根据提示词生成出电影感场景。湖面平台上,一名中年男子身穿西装演奏萨克斯,结合画面中较为萧瑟的场景,音乐也较为悲伤。根据用户提示,场景中还可以加入鲸鱼,天气也可以较为自然地改为雪天。
谷歌称,Genie 4在实时交互式模拟中引入了更高水平的真实感。该模型可以模拟空气动力学、碰撞等现实物理过程,生成的人物能够自然移动,对周围环境作出反应,用户还可以操控世界中的角色。
Genie 4还可以原生生成音频。每个模拟世界都带有与环境相匹配的声音,例如树叶间的风声和海滩上的海浪声。模型支持交互式对话,人物可以根据用户输入或世界中的事件即时交谈和作出反应。
在一段演示中,模型生成了一个完全由彩色玻璃构成的三维景观:半透明的河流穿过绿色田野,花朵、树木、山脉、云朵和太阳均呈现彩色玻璃或水晶质感。当小鹿涉水过河时,场景同步出现了流水声,展示出Genie 4根据画面事件实时生成环境音的能力。
二、Gemini 3.8 Flash拆解任务,Argon探索机器人模拟
谷歌将Gemini与Genie 4结合,生成世界前加入了推理层,因而能够模拟复杂的多步骤事件,并测试AI系统如何在不同环境中完成任务。
在实时运行过程中,Gemini 3.8 Flash充当循环中的引导Agent。Genie 4生成世界时,Gemini会持续观察场景,把目标拆分为一系列步骤,分析输入画面,跟踪任务进展,并确认每一步是否完成。当世界发生变化,或者用户在过程中进行干预时,Gemini会即时调整计划。
模型可以根据用户提示,在画面背景中生成流星,并引导画面中的鹤走向雪地中的钢琴。
谷歌称,通过这种协同,Genie 4可以构建具备可靠因果关系、程序化行为和多步骤推理能力的模拟世界。
谷歌还在探索Gemini 4 Argon、Genie 4与Gemini Robotics的结合。在演示中,Argon把用户提出的任务拆解为多个步骤,以文字提示的形式逐步传递给Genie 4。通过上述合作,模型可以模拟Apptronik的Apollo人形机器人下跳棋,将任务拆解为实时执行步骤。
三、从电影预演到历史复原,测试者探索Genie 4的应用场景
谷歌称,Genie 4目前仍处于早期实验阶段。为了解交互式世界模型如何支持现实工作流程,以及模型还需要在哪些方面提升,谷歌已经与创意产业、新闻、教育、游戏和工程领域的受信任测试者展开合作。
在创意方向上,电影制作人可以把Genie 4当作快速预演和构思工具,进入一个实时模拟场景,连续运行多次“拍摄”,并即时调整摄像机角度、灯光、对白和动作。
在历史场景和沉浸式照片方面,新闻摄影师正在测试如何将一张二维档案照片快速转化为对应环境的模拟世界。相关团队还在探索,通过具有人物和动态变化的世界,帮助用户体验历史空间,或观察山洪、野火等短期环境事件的发展。
在交互体验设计方面,游戏开发者和创意技术人员可以通过自然语言提示词,在几秒内把最初的创意转化为可探索原型,并在编写引擎代码之前测试视觉风格、材质效果和交互机制。企业合作伙伴则在评估Genie 4能否快速生成不同产业的场景,并据此找出模型需要改进的部分。
谷歌还将Genie 4视为混合世界模型的一部分。未来的世界模型有望结合代码和语言模型的逻辑、结构化推理能力,以及像素级模拟的感官表达能力。Gemini负责理解世界结构并规划叙事时间线,Genie则负责生成即时的物理现实,呈现世界的外观、声音和反应。
结语:世界模型开始从生成画面走向持续运行
Genie 4生成逼真画面的同时,让模拟世界能够持续运行,处理物理变化、人物行为、环境声音、互动对白和多步骤任务。
目前,Genie 4仍处于研究预览阶段,长期运行中的细节漂移、复杂物理交互和空间准确性仍待改善。随着模型向Project Genie、Gemini API和Google AI Studio逐步开放,世界模型能否从演示场景走向稳定、可控的实际工作流,仍有待进一步验证。
News is gathered automatically from public robotics & AI feeds on a schedule.
Related
ANYbotics begins delivering ANYmal X legged robot for explosive atmospheres
ANYbotics has designed the ANYmal X inspection robot to comply with the strictest safety standards of the oil, gas, and chemical industries. The post ANYbotics begins delivering ANYmal X legged robot for explosive atmospheres appeared first on The Robot Report .
Embotech and BMW move 1M vehicles with automated driving technology
Embotech is automatically moving 3,500 vehicles around the clock daily across four BMW sites in the U.K. and Germany. The post Embotech and BMW move 1M vehicles with automated driving technology appeared first on The Robot Report .
Xpanner launches autonomous pile driver for solar farm contruction
Xpanner's new X1 Piling R6 robot autonomously drives solar posts with one operator, improving placement accuracy while cutting on-site labor. The post Xpanner launches autonomous pile driver for solar farm contruction appeared first on The Robot Report .
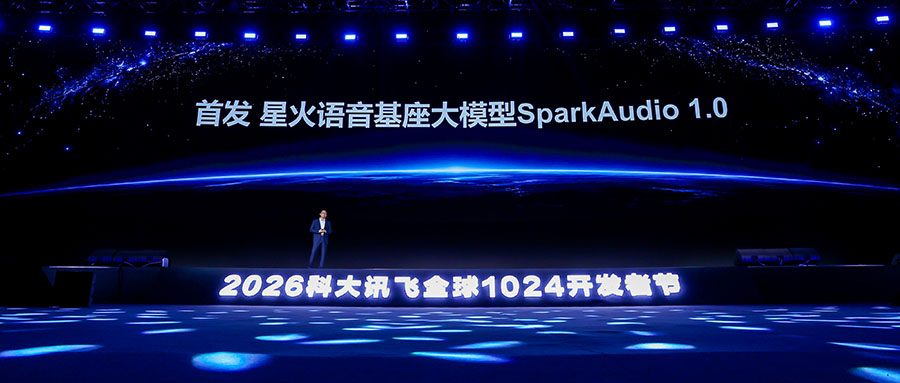
数种声源混叠也能精准解析!科大讯飞亮出语音基座大模型SparkAudio 1.0
智东西 作者 | 程茜 编辑 | 漠影 如果让你扮演一名刑侦助手,你能从下面数种声源混叠的音频里分析出受害人的所在位置吗? document.createElement('audio'); https://oss.zhidx.com/0c33ff14052d1fbdf18a5c8d2c597ae0/6ae0ca80/uploads/2026/10/6ae18c1fde699_6ae18c1fd995f_6ae18c1fd992b_%E9%9F%B3%E9%A2%91%E7%89%87%E6%AE%B51.wav 讯飞最新发布的语音基座大模型 SparkAudio 1.0 ,在几秒内就给出了答案
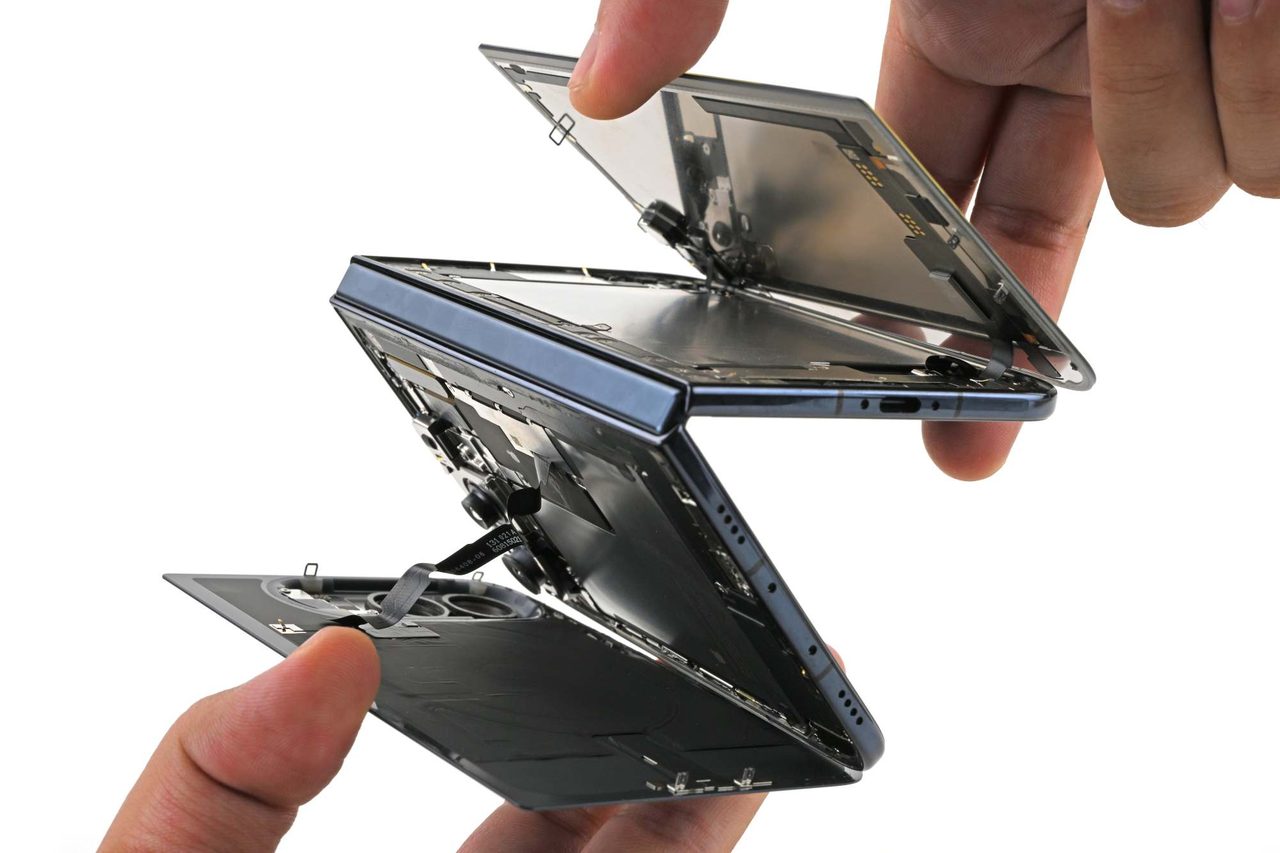
iPhone Duo 裂屏,是苹果新 CEO 接班后第一次「大考」
头图图片来源:iFixit 2011 年 9 月 30 日,苹果递交了一份名为「Flexible electronic devices」的专利申请。 它描述的是一台屏幕可以对折的设备,合起来能揣进口袋,靠传感器判断自己是开着还是合着。 这份专利 2015 年 1 月获得授权,发明人一共六位,其中一位叫特努斯(John Ternus)。 苹果 2011 年递交的折叠设备专利附图|图片来源:Apple 十五年后,2026 年 9 月 9 日,当年署名的这位工程师,第一次以苹果 CEO 的身份走上发布会舞台,发布的正是一台可以对折的 iPhone:iPhone Duo。 巧的是,十二年前的同一天,2
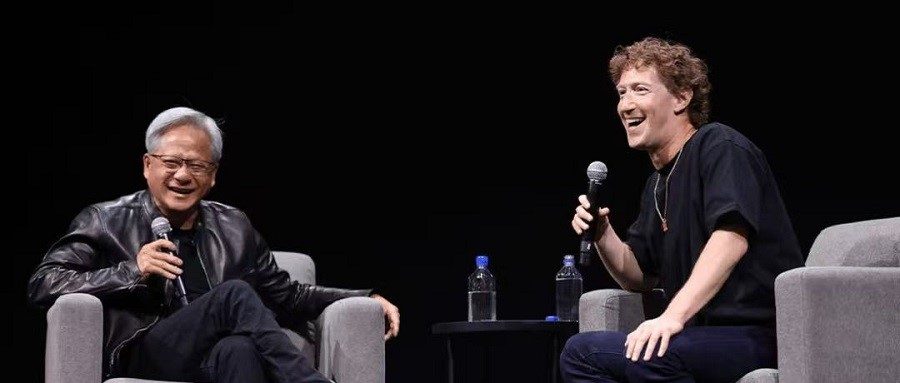
黄仁勋砸200亿,押注扎克伯格!
智东西 编译 | 陈骏达 编辑 | 李水青 智东西10月27日报道,今天,英伟达发布公告,称其将 在Meta的股权发行中投资 30亿美元(约合人民币200亿元) 。 同时, 双方将扩大在个人智能体产品Muse及Muse系列模型上的合作,以提升模型的推理和训练性能。 ▲英伟达公告(图源:X平台) 英伟达的这笔投资,是Meta更大融资计划的一部分。10月26日,Meta发布公告, 称其计划进行一轮950亿美元(约合人民币6335亿元)的募资 ,一方面通过承销公开发行股票筹集350亿美元,随后通过按市价发行计划再筹集600亿美元,除了英伟达之外,AMD、博通也有意向投资Meta。 Meta 预计,其