刚刚,美国最强开源模型发布!放中国只能排第七?
智东西
编译 | 杨京丽
编辑 | 李水青
智东西10月16日消息,今天凌晨,Meta发布 开放权重模型Muse Spark Open ,总参数量达 8160亿 ,每次推理激活 420亿 参数,支持 100万Token上下文 窗口。该模型原生支持 多模态 ,主攻 编程和Agent任务 ,重点面向需要长时间执行的任务、复杂软件工程和多步推理。
Meta称,这是 迄今能力最强的美国开放权重模型 。借助最新版MLX框架,Muse Spark Open可在两台搭载苹果M5 Ultra芯片的Mac Studio上运行,将大模型编程、视频处理等Agent工作流搬到桌面端。
Meta创始人马克·扎克伯格也在X上发文称,得益于 与苹果新CEO约翰·特努斯及苹果团队的合作 ,Muse Spark Open在新款Mac Studio上运行良好,并晒出了两台Mac Studio搭配显示器的桌面照片。
特努斯在评论区回应:能够直接在桌面端高效运行令人惊叹,Mac Studio正持续拓展端侧AI的边界。
在第三方评测机构Artificial Analysis的开放权重模型智能指数榜单上,Muse Spark Open(xhigh)获得39分,低于 MiMo-V2.6-Pro 的46分、 GLM-5.3 的45分,以及 Step 5 Preview、Kimi K3 等模型的测评成绩,与 DeepSeek V4.1 Flash 持平。而蚂蚁百灵刚开源的Ling-3.1-flash也取得41分,领先Meta。
目前,开发者可通过Baseten、Fireworks AI、Groq、Modal、Nebius、OpenRouter和Together AI等平台的API使用Muse Spark Open,也可通过Amazon SageMaker AI、Google Cloud Model Garden、Hugging Face和Microsoft Foundry Models下载模型权重。
该模型支持SGLang、vLLM、TensorRT-LLM、Hugging Face Transformers、苹果MLX、llama.cpp和Unsloth等主流推理框架,并针对AMD、苹果、英特尔和英伟达芯片进行了优化。开发者还可以使用PyTorch框架进一步定制模型。
开源地址:
https://huggingface.co/collections/meta-models/muse-spark-open
一、8160亿总参数、百万Token上下文,编程落后于多款国产开源模型
Muse Spark Open采用稀疏混合专家架构,总参数量为8160亿,每个Token激活约420亿参数,支持100万Token上下文窗口,可接收文本、图像、视频和音频输入。
基准测试方面,Muse Spark Open在部分Agent、知识推理和工具辅助多模态测试中领先,但在考察终端环境下编程与任务执行能力的Terminal-Bench 2.1中,其得分为76.4分,低于Qwen3.8-2.4T-A95B、GLM 5.3和Kimi K3;在软件工程测试DeepSWE 1.1中,其得分为60分,低于GLM 5.3的67分和Kimi K3的68分。
在考察真实职业场景中知识工作任务完成能力的GDPval-AA v2中,Muse Spark Open得分为1401分,同样低于Qwen3.8-2.4T-A95B、GLM 5.3和Kimi K3。
二、两台M5 Ultra Mac Studio本地运行,能改代码、剪视频
为支持桌面端部署,Muse Spark Open针对最新版MLX框架和搭载M5 Ultra芯片的Mac Studio进行了优化。
Meta称,苹果统一内存架构允许每台Mac Studio的集成GPU使用最高512GB内存,两台设备合计可提供约1TB统一内存,从而容纳完整模型。M5 Ultra的内存带宽为1.2TB/s,可支持读取每个Token计算所需的部分模型参数。
由此,两台Mac Studio可以像一台拥有约1TB统一内存的超级计算机一样协同工作。
Meta使用由Muse Spark Open驱动的Muse Code,测试了一系列完全在设备本地运行的Agent工作流。
在编程场景中,模型为开源Mastodon客户端Ice Cubes完成了实际的iOS代码修改,任务覆盖修复Bug、添加新功能,以及完成整个项目的构建。
在视频处理场景中,模型能够操作视频剪辑软件DaVinci Resolve,逐帧检查素材,寻找更适合保留的片段,并将画面裁剪为竖屏。
三、适配多家芯片与推理框架,进行安全后训练
Muse Spark Open发布时已适配SGLang、vLLM、TensorRT-LLM、Hugging Face Transformers、苹果MLX、llama.cpp和Unsloth等推理框架,并针对AMD、苹果、英特尔和英伟达芯片进行优化。
在推理性能方面,Meta为SGLang提供了可自动调优的定制Helion GPU内核。按照其公布的数据,这些内核在英伟达和AMD GPU上实现了1.03-3.95倍的内核级加速,在AMD MI350上带来的端到端性能提升为3%。
安全方面,Meta称,针对开放权重发布,Muse Spark Open进行了额外的安全后训练,并依据Meta超级智能扩展框架开展评估,达到了该框架要求的发布门槛。
结语:开放权重模型走向本地工作流,实际能力仍待验证
Muse Spark Open开放权重,为开发者部署和定制大模型提供了更多选择,针对苹果桌面设备的适配也拓展了本地Agent的应用空间。
不过,从基准测试成绩及第三方评测看,其综合能力及部分编程表现仍落后于国产开放权重模型。在真实任务中能否稳定、高效地完成复杂工作,还需要更多独立测试和实际应用来验证。
Les actualités sont collectées automatiquement depuis des flux publics robotique & IA.
Articles liés
Stryker invests $400M into CMR Surgical
Stryker plans to serve as the exclusive sales agent in the U.S. for the Versius robotics portfolio from CMR Surgical. The post Stryker invests $400M into CMR Surgical appeared first on The Robot Report .
How ADI is helping robotics startups scale
Robotics businesses need help keeping up with innovations as they scale. Analog Devices Inc. or ADI is offering its Emerging Tech Hub. The post How ADI is helping robotics startups scale appeared first on The Robot Report .
Anthropic三季度收入1124亿,还盈利了
智东西 编译 | 杨京丽 编辑 | 李水青 智东西10月15日消息,据The Information援引知情人士消息,当地时间10月14日,Anthropic在旧金山举行的潜在IPO(首次公开募股)投资者会议上披露,该公司第三季度营收达到 168亿美元(约合人民币1123.92亿元) ,环比增长约 45% ,超过2025年全年营收的 3.6倍 。 会上,Anthropic披露,其第三季度已实现调整后 盈利 ,经营性现金流为正。今年前三季度累计调整后营业利润率达到 11% ,这一指标剔除了股权激励等重大成本。此次投资者会议是Anthropic筹备IPO过程的一部分。据The Informatio
OpenRouter周榜全球第二,这个国产模型终于开源了
智东西10月15日报道,刚刚, 一款刚登上OpenRouter Token全球使用量周榜第二的大模型,开源了! 阶跃星辰正式开放 Step 5 Preview 的模型权重,BF16、FP8两个版本同步上线HuggingFace和ModelScope。 Hugging Face:https://huggingface.co/stepfun-ai/Step-5-Preview ModelScope:https://modelscope.cn/models/stepfun-ai/Step-5-Preview Step 5 Preview采用稀疏MoE架构, 总参数量600B、激活参数仅27B ,支持
万字深度解密:华为麒麟2026韬定律大量技术细节首披露
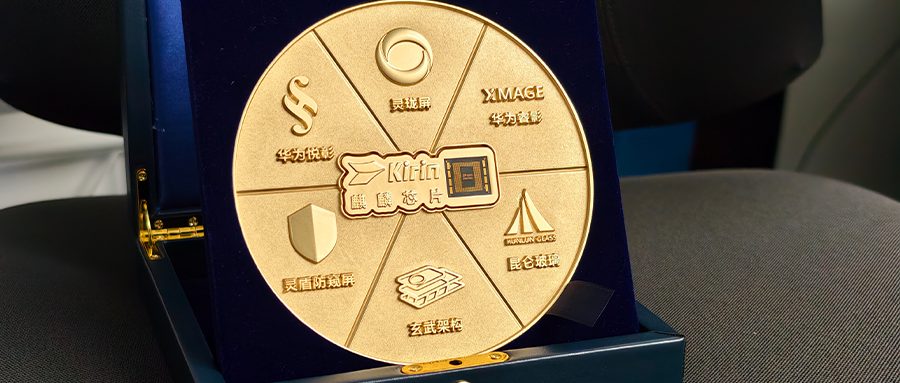
智东西 作者 | 云鹏 编辑 | 李水青 智东西10月15日报道,近日,华为在上海练秋湖畔举办了一场为期两天的深度技术沟通会,从 影像、屏幕、可靠、定位、声音5大方向9大技术 品牌,到 麒麟9050系列背后韬定律、逻辑折叠、混合键合 等海量技术细节,华为首次详细对外解读。 主讲人分别为第一天的 华为终端BG CTO李小龙, 以及第二天的 华为半导体业务无线终端芯片产品管理部部长徐松余。 值得一提的是,这也是 时隔6年,华为再次对外详细解读麒麟芯片, 其重要意义不言而喻。 两天的沟通会信息量极大,可以说干货多到爆: ·内含 300多个零部件 的影像“巨炮” Z10模块相机 如何突破光学硬件的物理
剑指博通,这家国产互连芯片公司藏不住了
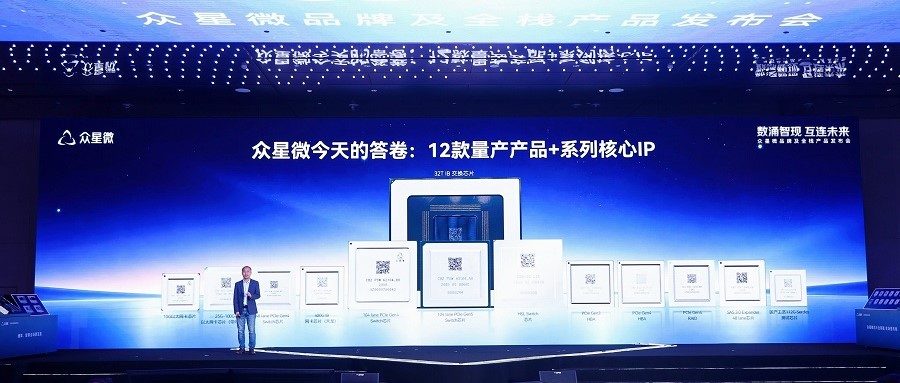
智东西 作者 | 陈骏达 编辑 | 漠影 AI算力的竞争,不只发生在芯片内部,也发生在芯片与芯片之间。 一颗芯片的峰值算力再高,也不意味着数百颗、数千颗芯片组成的集群就能发挥出相应的性能。数据能否高速传输,计算、存储与网络能否高效协同,都会影响整套系统的实际表现。 随着AI集群规模愈发庞大,互连已不再只是连接硬件的配套环节,而是决定算力能否充分释放的重要一环。面临这一挑战,国产互连厂商究竟应该如何破局? 今天,在国产互连芯片赛道深耕6年、相对低调的 无锡厂商众星微 ,在品牌及全栈产品发布会上 首次集中展示其全场景高性能互连芯片平台 。该平台围绕通用计算互连与智能计算互连展开布局,覆盖存储、网络