成本压至 1/10!告别人海采数,具身数据Token工厂要如何跑通?
智东西
作者 | 王涵
编辑 | 漠影
过去几年,AI的两次规模化发展,都离不开 充足的数据供给 。
大语言模型可以直接利用互联网上积累多年的网页和代码数据,通过持续训练提升模型能力;自动驾驶企业则可以依靠量产车辆的影子模式(Shadow Mode),从真实道路中持续收集行驶数据和人工接管记录。以特斯拉为例,其通过全球数百万辆量产车,将数据采集融入日常驾驶过程,不需要额外组织大规模人工采集。
但到了具身智能领域,这样的数据供给条件并不存在。
过去两年,行业主要依靠真机遥操作和第一视角(EGO)可穿戴设备采集数据,累计获得的真机有效数据和EGO数据也 只有数百万小时 。对于已经投入大量资金的机器人公司和大模型企业来说,想要获得足够规模的高质量训练数据,依然不容易。
10月30日,空间智能公司影溯(InSpatio)在杭州落地 全国首个具身仿真数采中心 。影溯预计,该中心将 单月生产100万小时仿真训练数据 ,单条数据综合成本约为传统真机遥操作采集的 1/10 。
全行业花费两年积累数百万小时数据,影溯凭什么计划将产能提升至单月百万小时?要回答这个问题,我们需要先看清当前具身智能数据采集面临的困难,以及影溯如何将现实场景转化为机器人训练数据。
一、 为什么现在的具身行业,做不到大批量的数据供给?
合格的具身Token需要同时包含三个要素,即 三维空间观测、真实物理接触反馈和可执行动作序列 。
也就是说,数据不仅要记录机器人看到了什么,还要包含机器人如何与物体交互,以及动作发生后产生了怎样的变化。
围绕这些要求,目前行业主要有 2 条 数据获取路径:一条是在物理世界,通过真机和可穿戴设备采集;另一条是在数字世界,利用三维建模和物理仿真生成数据。但渐渐地,两条路径都开始出现效率瓶颈。
1、去物理现场硬采:受限于时间、环境和场地
真机遥操作是目前获取机器人动作数据的主要方式之一,但采集效率并不高。
一名操作人员控制一台机器人工作一小时,扣除设备调试、故障处理和任务复位等时间,有效采集轨迹可能不到半小时。想要扩大数据规模,就需要增加机器人数量和操作人员, 采集效率十分受到物理时间和设备规模的限制。
为了降低机器人本体的投入,不少团队转向了EGO第一视角穿戴采集,通过记录人类在真实环境中的操作过程获取数据,但这种方式同样存在局限。
首先, 环境调整不够灵活。 EGO采集依赖真实场地,如果需要测试不同的杂物遮挡、光照条件或台面材质,就必须安排人员重新进入现场,搬动道具、调整布景,再次进行采集。
其次,很多真实场地并 不允许外部团队随意改造 ,例如营业中的商超、车间和药房等。即使训练中发现了问题,训练团队也未必能够回到原场地复现。
更不用说高危作业区、工业产线、脏乱差环境、安防场所和私人住宅等场景,还存在严格的准入限制,外部团队和设备很难进入。
2、向数字世界要产能:受限于场景建模效率
相比真实环境采集,仿真能够在虚拟环境中反复调整场景和任务,减少对真机和人工的依赖。但仿真平台本身并不能直接提供训练数据,首先要解决的就是 场景建模效率问题 。
以Isaac Sim等物理仿真引擎为例,平台提供了机器人运行和物理交互的模拟环境,但房间搭建、物体建模、关节绑定、碰撞边界设置,以及摩擦系数等物理参数,仍需要人工处理。找3D美术师从头搭建一个可交互房间,往往需要几天甚至几周, 成本和时间投入都不低 。
那能不能直接让大模型完成建模?
最近,GPT-6 Astra、Atlas等模型都开始尝试三维场景自动生成,但距离直接用于机器人训练,还有不少问题需要解决。
以GPT-6 Astra调用Blender建模为例,其底层仍然需要经历“调整参数—渲染成图—比对参考图—再次调整参数”的反复过程。在这个流程下, 生成一个物体需要几十分钟,一个场景则需要数小时 。多轮推理和渲染更是会增加生成成本,程序化拼接出来的场景也容易带有明显的CG感。
除了效率和成本,生成场景的真实性与一致性也很重要。
无论是通过代码参数拼接场景,还是通过单张图片推测物体未被拍摄到的部分,如果缺少真实空间测量作为约束,就很难保证不同视角下的几何结构、整体空间尺度和物理关系一致。这些误差会影响机器人在仿真环境中的操作,也会增加从仿真到现实的迁移难度,也就是业内所说的 Real2Sim Gap 。
真机和EGO采集受制于时间、场地及环境调整,仿真数据生产则面临人工建模效率低、AI生成成本高、场景真实性不足等问题。
如何快速获得能够支持机器人实际操作的数字场景,成为具身数据规模化生产亟需跨过的一道鸿沟。
二、 影溯的破局思路:用工业流水线逻辑,建一座具身Token工厂
AI算力中心常被称为AI时代的“Token工厂”,通过整合电力、芯片和原始数据,持续输出模型训练和推理所需的Token。
影溯在杭州落地的具身仿真数采中心,也采用了类似的思路。它通过 自研的Topos空间智能底座 ,将现实空间转化为可交互的数字场景,再用于生成机器人训练数据,一共拆成了 三道全自动工业产线 :
1、上游场景入厂:15分钟把真实场地搬进云端,替代按周计算的手工建模
针对上文所述问题,影溯将场景采集改为 多源轻量输入与原生3D生成 。
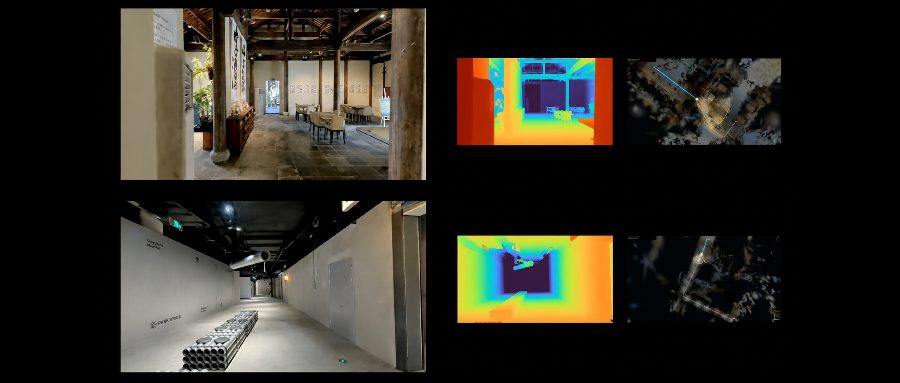
对于能够短暂进入的场地,影溯使用便携式设备进行扫描,设备进场 15分钟 即可完成上百平方米空间的采集。对于不方便进入的受限或私密场所,则可以使用现场人员拍摄的多视角视频和照片,或者调用原生3D场景生成能力,构建对应的数字环境。
原始数据进入Topos引擎后,系统通过算法完成 三个步骤 :
第一步是物体拆解。 系统自动识别水杯、药盒、抽屉、门把手等可操作物体,并将它们从背景中独立剥离,解决普通三维扫描中物体与场景容易粘连的问题。
第二步是盲区补全。 针对相机无法拍摄到的物体背面、底部,以及移走物体后留下的台面空洞,系统调用原生3D生成模型进行补全,生成完整闭合的三维模型。
第三步是物理标定。 系统为物体生成碰撞边界,赋予质量、摩擦系数等物理属性,并为柜门、抽屉配置旋转和滑移关节轴,使其能够直接进入物理仿真器。
经过这些处理,现实中的住宅、商超、餐厅和仓库等场景,就可以转化为可运行的数字场景。据影溯介绍,完成扫描后, 相关场景能够在几小时内完成转换 。
这样一来,经过数字化处理后,同一场景可以在仿真环境中反复使用,也可以调整物体位置、环境条件和交互方式,生成不同的机器人训练场景。
2、中游算力扩展:把现场搬道具和串行采集,变成云端的受控调整与并行合成
真实空间一旦拆解为可编辑的数字母本,EGO 和真机采集最头疼的环境调整难与单机串行瓶颈便迎刃而解。
在影溯的产线上,一个真实场景入库后可以反复调用。需要增加环境变化时,系统可以直接调整数字场景中的参数。之后,系统只需引入少量真实示范动作作为种子,就能在云端启动 多个仿真通道 ,并行规划和执行动作。
底层物理引擎会实时计算抓取、推挤、放置等操作产生的力学结果,并筛除穿模、滑落等失败尝试,最终 批量生成包含深度、位姿、接触力和动作语义等信息的具身Token 。
这种方法直接改变了具身数据的生产方式:数据产量将更多取决于数字场景的复用程度和云端并行算力规模。 原本需要人工反复布置和采集的工作,基本都可以转移到云端完成。
3、下游品控与闭环:拒绝同质化凑数,按模型短板定向补齐数据
数据规模扩大后,如何避免重复采集、保证数据有效性,也是影溯需要解决的问题。
影溯为场景统计设置了去重标准:所有场景都以独立、完整的房屋或经营场所建档。同一房间仅改变灯光或拍摄角度,只计作场景内部的变体,不重复计入场景总数。数据交付端,则按照空间几何(L1)、物理交互(L2)、任务闭环评测(L3)分级供给。
与此同时, 数据生产也与下游模型评测形成了闭环 。
当客户模型在测试中暴露出短板,例如遇到透明水杯、强反光台面或密集堆叠遮挡时频繁失败,影溯可以根据失败原因,在数字场景中定向生成一批相似的复杂环境,不必重新派人到现场搭建场景、采集数据。新生成的数据用于补充模型薄弱环节,也可以在同一套环境中进行回归验证。
结语:将物理空间作为原材料,具身需要自己的Scaling Law
语言模型之所以能沿着Scaling Law快速提升能力,前提是互联网替人类完成了文本数据的数字化汇集。
而机器人要走出实验室、进入千差万别的真实物理世界,始终面临一个数据转化难题——物理世界本身是连续、无序且无法直接交给模型训练的。
当行业里大多数团队还在靠增加机位、扩招采集员的线性方式逐步积累数据时,影溯给出了另一种解法:把物理空间当成原材料,用三维重建、生成模型与并行仿真搭起一座全天候运转的具身 Token 工厂。
当百万小时量级的物理交互数据开始像工业品一样按月排产,具身智能的大规模训练才有了稳定的数据基础。
News is gathered automatically from public robotics & AI feeds on a schedule.
Related
What AgTech founders get wrong about ROI
Connie Bowen, the founding general partner of Farmhand Ventures, discusses the importance of return on investment for AgTech developers. The post What AgTech founders get wrong about ROI appeared first on The Robot Report .
116亿元国产算力大单!大华股份拿下26.3亿
智东西 作者 | 李水青 编辑 | 云鹏 智东西11月2日消息,刚刚,智能物联龙头企业 大华股份 发布公告,确认旗下子公司浙江华启智慧科技有限公司(简称: 华启智慧 )中标中国移动超节点设备集中采购项目,中标金额约为 26.3亿元。 ▲大华股份公告 9月29日,中国移动发布“2026年至2027年新一代人工智能超节点设备集中采购项目”招标公告,计划采购AI超节点合计 20480卡 ,及配套Roce交换机448台、存储82套。 ▲招标公告部分截图 10月28日,招标人对标的项目的中标候选人情况进行公示, 华鲲振宇、宝德计算机、华启智慧、百信信息、神州鲲泰 五家公司进入中标候选人名单,拟中标份额分
美团发1.6万亿参数新模型,通用Agent测试超Opus-5,国产芯特别优化
智东西 作者 | 杨京丽 编辑 | 李水青 智东西11月2日报道,今日,美团LongCat团队发布面向 长程智能体任务 的原生多模态模型 LongCat-2.5 。 该模型总参数量为 1.6万亿 ,每个Token激活约 480亿参数 ,在LongCat-2.0的基础上,重点强化 原生视觉理解与智能体编程能力 。 在美团公布的自动化任务基准AutomationBench、通用Agent任务基准LongCatClawBench等几项基准测评中,LongCat-2.5均 领先Claude-Opus-5、GPT-5.6-Sol等模型 ;在终端操作基准Terminal Bench v4.0上,LongC
Muse人形机器人来了!小扎带队,中国造
智东西 编译 | 杨京丽 编辑 | 李水青 智东西11月1日消息,今日,据外媒The Information援引知情人士消息报道,Meta已与中国机器人公司 傅利叶 合作,打造出一款 名为“Max”的人形机器人原型 ,目前 已开始开发第二代产品 。 其中一位知情人士称,Meta与傅利叶仅用3个月就造出了这款 重约106磅(约48千克) 的人形机器人。这项工作的目标,是帮助Meta机器人部门进一步打磨未来产品,该产品后续有可能正式推出,目前尚未确定上市时间。 两名知情人士称,Meta机器人业务产品副总裁Li-Chen Miller曾在傅利叶位于上海的工厂 工作近两个月 ,共同推进这款原型机的开发
28 Zero-Day Findings in Less Than Two Days: What AI-Speed Discovery Means for Robotics
VicOne identified an initial set of 28 zero-day findings in less than two days using AI-assisted research across software and tools supporting the Physical AI ecosystem. The post 28 Zero-Day Findings in Less Than Two Days: What AI-Speed Discovery Means for Robotics appeared first on The Robot Report
Why physical AI is the next lucrative frontier
To prove its commercial value, physical AI must get past funding enthusiasm and move into production environments. The post Why physical AI is the next lucrative frontier appeared first on The Robot Report .